【Day22】Google Sheets - 客戶:我希望新資料插在最前面 & 談需求變更

這篇文章寫於 2020 年,文中的工具與版本可能已經更新,實作時請以官方文件為準。
本文目錄
在驗收階段你就知道一個好的需求規格書有多麼重要
今日目標
1. 了解驗收過程中需求規格書的重要性
2. 談需求變更
3. 將新的爬蟲資料寫到最前面,日期為由近而遠的排序
3.1 插入一個空白欄位:insertEmptyCol
3.2 把空白欄位更新成最新的追蹤人數資訊
1. 了解驗收過程中需求規格書的重要性
驗收的過程就是按造需求規格上的驗收項目一一測試,所以如果沒有需求規格書或是需求規格書寫得太不完善,你在驗收的過程會一直被凹新功能,而這些功能基本上只能忍氣吞聲吃下去,畢竟這是因為你在一開始沒談好規格的歷史業障,這就是我在Day 1提到需求規格書的重要性
2. 談需求變更
反過來如果你需求規格寫得夠好,在驗收的階段你會有很多賺外快的機會,因為大部分的客戶在驗收階段才想到他們實際上還需要哪些功能
對於這些多出來的功能我一律列入需求變更,因為這些需求並不在原合約內所以你可以將客戶的新需求記錄下來依功能報價讓客戶自己決定需要新增哪些功能
根據個人經驗,在結案後你會發現這些多出來的需求變更可能占總外包費的 20%~40% 不等,所以各位在接案時千萬不要因為覺得麻煩沒有好好寫需求規格書啊!你這樣的做法完全在跟自己的錢包過不去,讓自己成為免費勞工。
下面用今天要完成的需求變更舉例:
客戶:我測試了幾天覺得爬蟲蠻穩定的,但最新的爬蟲資料都寫在最後面,這讓我要滑到最後面才知道最新資料,他能不能新資料都寫在最前面啊 (客戶提出需求變更)
我:您的意思是要將新的爬蟲資料寫到最前面,Google Sheet 上呈現的是日期由近而遠的排序嗎? (確認需求變更的邏輯)
客戶:對,麻煩了
我:不過這項需求並不在原本的需求規格書上面,原本的需求規格書只提到爬蟲日期為欄,粉專標題為列,並沒提到排序方面的需求;經過評估這個功能需要額外的費用XXX,您可以接受嗎? (提出需求規格書上面的規格做佐證,並說明這個新功能需要加收多少費用)
客戶:恩…可以
我:我把這項規則加到需求規格書的後面,您確認完後我就會開始實作 (讓客戶確認規格及價格後在開始實作)
3. 將新的爬蟲資料寫到最前面,日期為由近而遠的排序
因為沒找到可以一步完成的解法,所以我將這個需求拆成兩個步驟:
- 先在第二欄插入一個空白欄位
- 把空白欄位更新成最新的追蹤人數資訊
3.1 插入一個空白欄位:insertEmptyCol
在Google Sheets中插入空白欄位的部分請參考官方的文件,這裡有個需要注意的點:
- 我們觀察到 Google 插入欄位的 api 在 range 的參數上需要
sheet_id來能執行,而這隻函式會被writeSheet函式呼叫,所以下一步我們要對他做一些調整
async function insertEmptyCol (title, sheet_id, auth) {//插入空白欄位
  const sheets = google.sheets({ version: 'v4', auth });
  const request = {
    // The ID of the spreadsheet
    "spreadsheetId": process.env.SPREADSHEET_ID,
    "resource": {
      "requests": [{
        "insertDimension": {//插入新欄位
          "range": {
            "sheetId": sheet_id,
            "dimension": "COLUMNS",
            "startIndex": 1,//代表插入範圍從第一欄開始到第二欄結束
            "endIndex": 2
          },
          "inheritFromBefore": true
        },
      }]
    }
  };
  try {
    await sheets.spreadsheets.batchUpdate(request)
    console.log('update sheet:' + title + ' new column')
  }
  catch (err) {
    console.log('The API returned an error: ' + err);
  }
}
3.2 把空白欄位更新成最新的追蹤人數資訊
因為insertEmptyCol這個函式需要用到用到 sheetId 的參數,我們需要對以下程式做調整:
-
updateGoogleSheets:還記得 getFBIGSheet 會回傳 sheets 的資訊嗎?現在我們就需要裡面的title、idconst sheets = await getFBIGSheet(auth)//取得線上FB、IG的sheet資訊 // 寫入各自的Sheet for (sheet of sheets) { if (sheet.title === 'FB粉專') { await writeSheet(sheet.title, sheet.id, fb_result_array, auth) } else if (sheet.title === 'IG帳號') { await writeSheet(sheet.title, sheet.id, ig_result_array, auth) } } -
writeSheet:-
傳入
sheet_id參數讓 insertEmptyCol 使用async function writeSheet (title, sheet_id, result_array, auth) -
先插入空白欄位後再寫入追蹤人數
// 插入空欄位
await insertEmptyCol(title, sheet_id, auth)
// 寫入追蹤人數
await writeTrace(title, trace_array, auth)
因為取得最後一欄的函式用不到了,請將
getLastCol、toColumnName刪除 -
執行程式
-
在專案資料夾的終端機(Terminal)執行指令
yarn start -
在終端機我們可以看到事先插入新欄位再更新資料
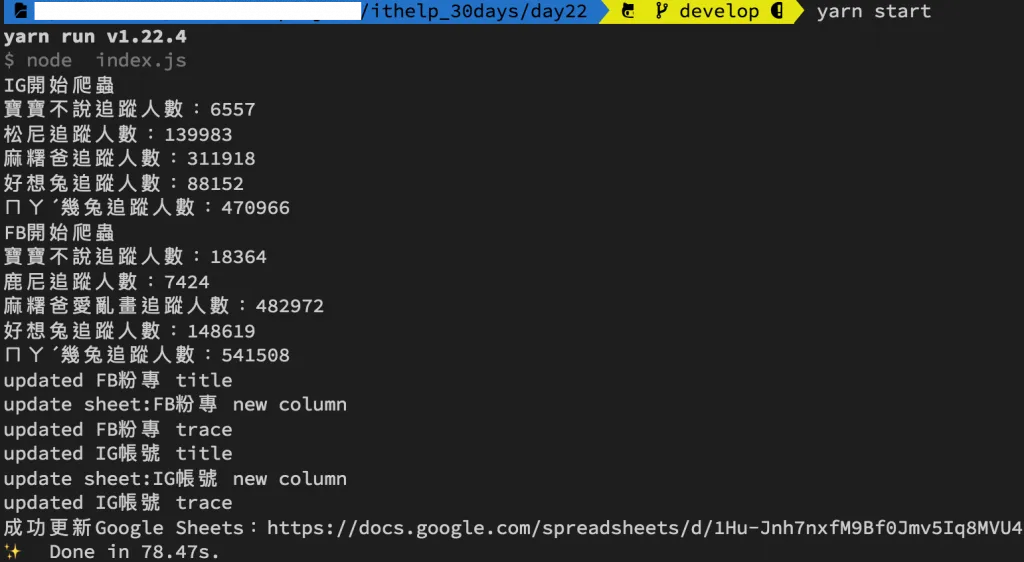
-
確認新的爬蟲資料有正確插入到 Google Sheets 第二欄
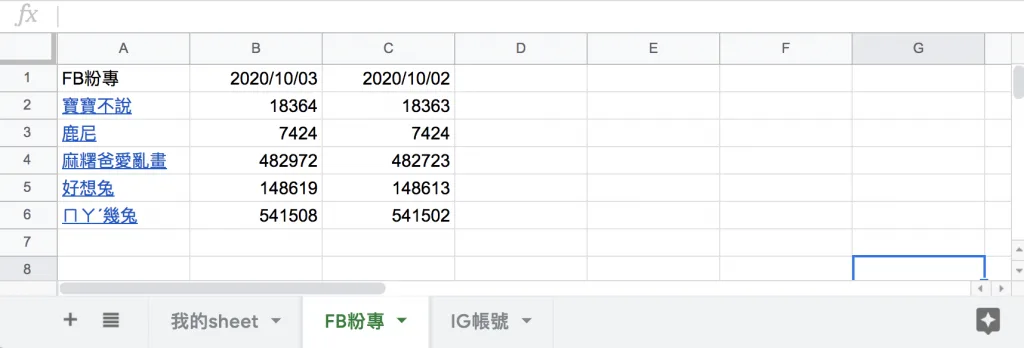
如果你在同一天測試,你可以把之前爬蟲日期改成
old方便辨識
ℹ️ 專案原始碼
- 今天的完整程式碼可以在這裡找到喔
- 我也貼心地把昨天的把昨天的程式碼打包成壓縮檔,你可以用裡面乾淨的環境來完成業主要求的需求變更吧
- 請記得在終端機下指令 yarn 才會把之前的套件安裝
- windows需下載與你chrome版本相同的chrome driver放在專案根目錄
- 要在tools/google_sheets資料夾放上自己的憑證,申請流程請參考Day17
- 調整fanspages資料夾內目標爬蟲的粉專網址
- 調整.env檔
- 填上FB登入資訊
- 填上FB版本(classic/new)
- 填上IG登入資訊
- 填上SPREADSHEET_ID
在許多人的幫助下,本系列文章已出版成書,並添加了新的篇章與細節補充:
- 加入更多實務經驗,用完整的開發流程讓讀者了解專案每個階段要注意的事項
- 將爬蟲的步驟與技巧做更詳細的說明,讓讀者可以輕鬆入門
- 調整專案架構
- 優化爬蟲程式,以更廣的視角來擷取網頁資訊
- 增加資料驗證、錯誤通知等功能,讓爬蟲執行遇到問題時可以第一時間通知使用者
- 排程部分改用 node-schedule & pm2 的組合,讓讀者可以輕鬆管理專案程序並獲得更精確的 log 資訊
有興趣的朋友可以到天瓏書局選購,感謝大家的支持。
留言載入中…