【Day8】selenium-webdriver:爬蟲起手式,帶你認識所見即所得的爬蟲工具

這篇文章寫於 2020 年,文中的工具與版本可能已經更新,實作時請以官方文件為準。
本文目錄
為什麼選爬蟲作為主題?
在決定以爬蟲作為主題時有朋友勸我不要寫這類有爭議的主題,但因為以下幾點我還是選了這個主題:
- 爬蟲道德觀:有些網路文章道德觀崩壞,把一個好的技術變成智慧財產的盜賊
- 中文資源缺乏,技術過時:中文的教學文章較少,許多範例的技術到今天已經無法使用了
- 缺乏系統性的整合:網路上的資源相對零碎,學習上缺乏系統性,容易在學習過程中遇到問題而半途而廢
學習爬蟲對我有什麼好處?
- 如果你是工程師
- 最直接的好處就是讓你在未來職涯上有更多的選擇
- 可以大量訓練你對網頁架構的認知
- 當你學會爬蟲時,你就能寫出相對來說反爬蟲的網頁了
- 如果你是行銷廣告、電商小編
- 你可以透過爬蟲來了解網路世界在資料這塊的邏輯
- 就算你看完文章後還是無法完全掌握,但當你請工程師來撰寫爬蟲時,你能很具體地說出你的需求並與工程師溝通順暢
- 我認為掌握分析資料能力的人才最有機會做出能說服公司的策略
今日目標
- 知道如何選擇適合的爬蟲工具
- 使用 selenium-webdriver 套件開啟瀏覽器:
openCrawlerWeb - 解決 windows 無法自動讀取 chromedriver.exe 路徑的問題
- 寫判斷 Driver 是否設定的函式:
checkDriver
- 寫判斷 Driver 是否設定的函式:
- 將
checkDriver整合進openCrawlerWeb
1. 如何選擇適合的爬蟲工具?
在Day5有提到尋找工具的方法,現在我們依序來說明:
- 官方資源
- 由於近年 FB & IG 的 api 改版頻繁,加上各式各樣權限的限制導致我們連公開資料都無法得到,所以在這裡我們放棄使用官方提供的 api
- 網路資源
- 透過下關鍵字我們可以看到很多人分享爬蟲的經驗,我們把這些經驗中看起來能用的套件記錄下來
- npm 套件
- 先在 npm 官網 確認這些套件健康程度,太少人用或太久沒更新的就淘汰掉,接著進入實際測試確認是否符合專案需求,以下是我當時找到的資源並附上實測後的分析:
- request & cheerio
- 下關鍵字候第一個找到的資源,使用範例程式測試後確認他可以透過網址抓到網頁元素並進行分析
- but…他在 FB、IG 面前毫無用武之地,因為 FB 會偵測你使用的瀏覽器,所以在第一關他就陣亡了
- selenium-webdriver
- 基本上他是一個無論是什麼網頁都能夠爬蟲的工具了,我認為非常適合新手使用
- 工具運行時會開啟一個瀏覽器,這個瀏覽器會依據撰寫的腳本來模擬人類操作的每個步驟
- 所見即所得,看得到的資訊都能夠抓下來,學習起來非常容易且直覺,所以這是本專案最後選擇的工具
- Puppeteer
- 操作邏輯與 selenium-webdriver 非常類似
- 預設附帶 Chronium 瀏覽器,不會有瀏覽器匹配問題(但是只能用這個瀏覽器QQ)
- 只能使用 Node.js 撰寫,不像 selenium-webdriver 有多種語言的 binding
- request & cheerio
- 先在 npm 官網 確認這些套件健康程度,太少人用或太久沒更新的就淘汰掉,接著進入實際測試確認是否符合專案需求,以下是我當時找到的資源並附上實測後的分析:
2. 使用 selenium-webdriver 套件開啟瀏覽器:openCrawlerWeb
我的文章會會依據需求使用到它的各種功能,如果有迫不及待的小夥伴也可以先去官網來更深刻的了解他
-
selenium-webdriver前置環境安裝-
先在終端機(Terminal)下指令安裝他
yarn add selenium-webdriver -
本專案使用的模擬器是 chrome,電腦還沒裝的請先下載
-
因為跑 selenium 需要用到 driver,大家可以依照自己的作業系統做設定
- mac 作業系統
- 如果你用的電腦是 mac,恭喜你,不要需要額外下載 chrome driver 就能夠直接寫使用(不過 chrome 還是要下載)
- windows 作業系統
-
先確認自己 chrome 版本:將
chrome://settings/help貼到你的網址列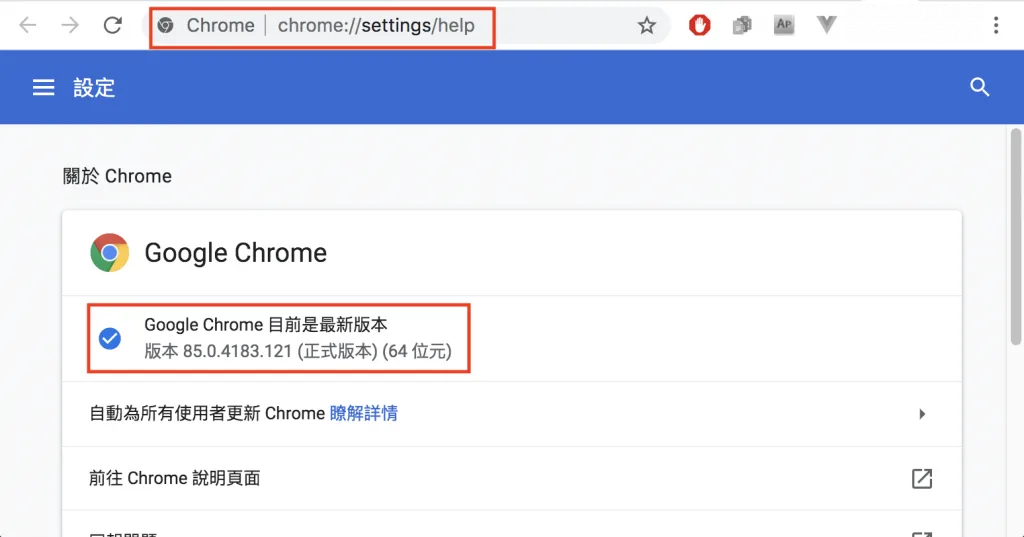
-
下載與你 chrome 版本相同的chrome driver
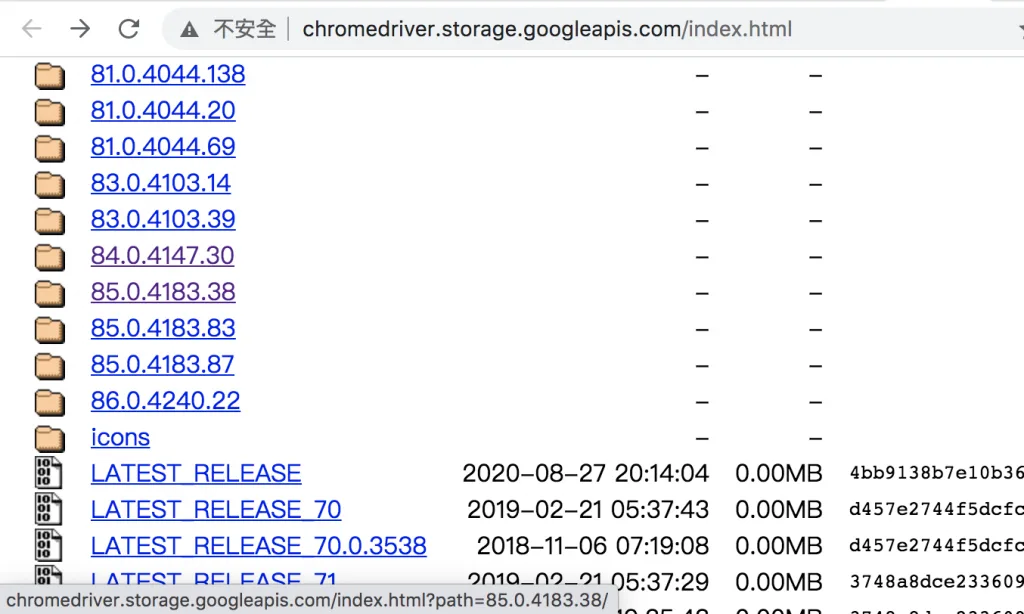
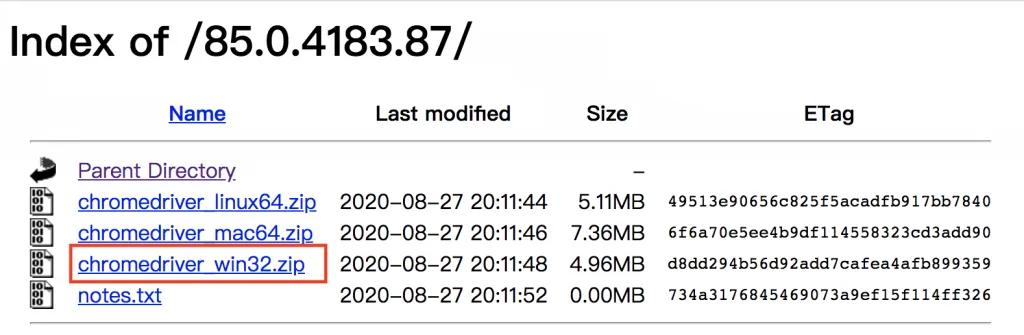
-
下載的檔案解壓縮後將
chromedriver.exe 放到專案根目錄下
-
- mac 作業系統
-
-
用
openCrawlerWeb函式打開爬蟲用網頁-
因為 selenium-webdriver 是使用非同步函式建立瀏覽器(browser),所以我們需要加上 await 明確告訴程式必須建立完瀏覽器才能打開網頁
PS. 因為 javascript 支援非同步語法,所以我們必須很明確地告訴程式他要執行的順序(在 async 的函式中用 await,是標明必須等待這項工作完成才能進入下一步),否則他跑起來的順序跟你想的不一樣 (並非完成前面工作才執行下一步的順序),想更深入理解的朋友可以參考這篇文章喔
index.js
require('dotenv').config(); //載入.env環境檔 const webdriver = require('selenium-webdriver') // 加入虛擬網頁套件 async function openCrawlerWeb() { // 建立這個browser的類型 let driver = await new webdriver.Builder().forBrowser("chrome").build(); const web = 'https://www.google.com/';//填寫你想要前往的網站 driver.get(web)//透國這個driver打開網頁 } openCrawlerWeb()//打開爬蟲網頁 -
-
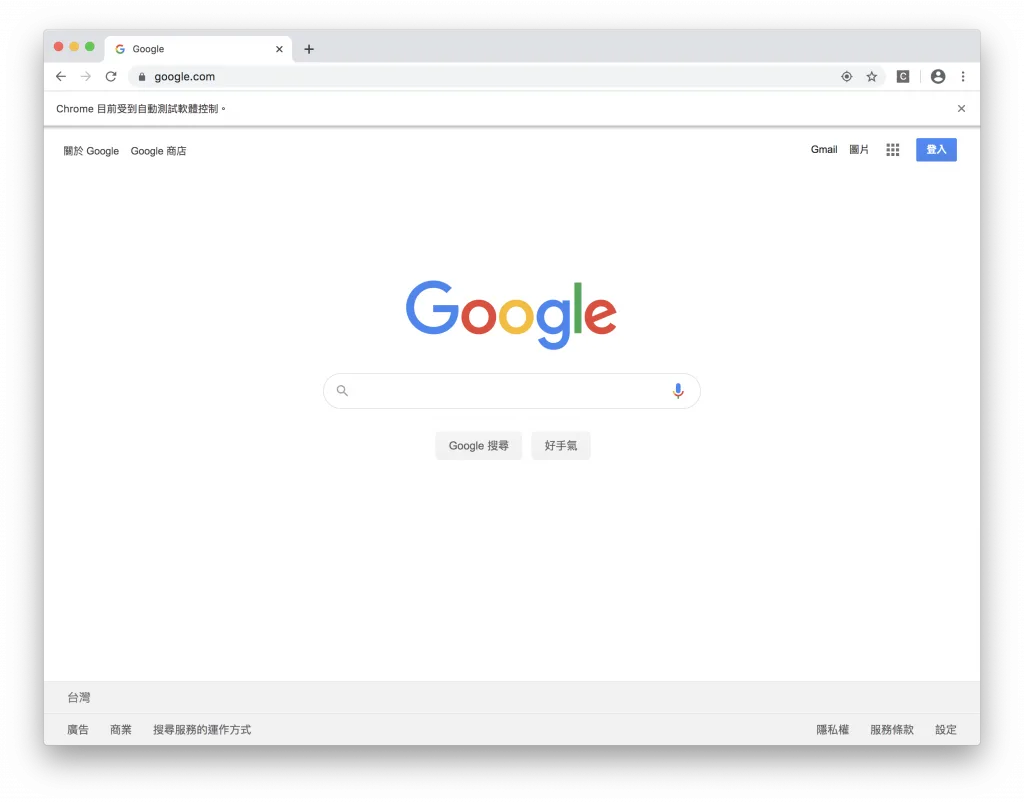
執行程式
在專案資料夾的終端機(Terminal)執行指令yarn start如果執行順利,你會看到 chrome 應用程式自動打開並且進入 google 的首頁
3. 解決 windows 無法自動讀取 chromedriver.exe 路徑
因為有人回報部分 windows 就算把 chromedriver.exe 放在專案根目錄也讀不到,所以特別寫了一個 checkDriver 的函式,邏輯如下:
- 判斷電腦是否有預設的 chromedriver
- Yes → 無須設定
- No → 確認路徑下是否有
chromedriver.exe的檔案- Yes → 設定 driver 路徑
- No → 無法設定 driver 路徑回傳 false
- 備註
- try-catch:顧名思義就是先 try,如果發生問題就會 catch 並執行錯誤處理;之後會有文章深入討論 try-catch 對專案的重要性
- __dirname:目前檔案所在的資料夾路徑
const chrome = require('selenium-webdriver/chrome');
const path = require('path');//用於處理文件路徑的小工具
const fs = require("fs");//讀取檔案用

function checkDriver() {
    try {
        chrome.getDefaultService()//確認是否有預設
    } catch {
        console.warn('找不到預設driver!');

        //'../chromedriver.exe'記得調整成自己的路徑
        const file_path = '../chromedriver.exe'
        //請確認印出來日誌中的位置是否與你路徑相同
        console.log(path.join(__dirname, file_path));

        //確認路徑下chromedriver.exe是否存在
        if (fs.existsSync(path.join(__dirname, file_path))) {
            //設定driver路徑
            const service = new chrome.ServiceBuilder(path.join(__dirname, file_path)).build();
            chrome.setDefaultService(service);
            console.log('設定driver路徑');
        } else {
            console.error('無法設定driver路徑');
            return false
        }
    }
    return true
}
-
將 chromedriver.exe 放到根目錄後記得在 .gitignore 把它加進去忽略清單喔,他屬於不需要版控的檔案.gitignore
node_modules
.env
chromedriver.exe
4. 將checkDriver整合到openCrawlerWeb
在建立瀏覽器之前,我們先用 checkDriver 函式來確認 Driver 是否是設定,如果無法設定會跳出錯誤提醒,統整後程式如下
index.js
require('dotenv').config(); //載入.env環境檔
const webdriver = require('selenium-webdriver') // 加入虛擬網頁套件
const chrome = require('selenium-webdriver/chrome');
const path = require('path');//用於處理文件路徑的小工具
const fs = require("fs");//讀取檔案用

function checkDriver() {
    try {
        chrome.getDefaultService()//確認是否有預設
    } catch {
        console.warn('找不到預設driver!');

        //'../chromedriver.exe'記得調整成自己的路徑
        const file_path = '../chromedriver.exe'
        //請確認印出來日誌中的位置是否與你路徑相同
        console.log(path.join(__dirname, file_path));

        //確認路徑下chromedriver.exe是否存在
        if (fs.existsSync(path.join(__dirname, file_path))) {
            //設定driver路徑
            const service = new chrome.ServiceBuilder(path.join(__dirname, file_path)).build();
            chrome.setDefaultService(service);
            console.log('設定driver路徑');
        } else {
            console.error('無法設定driver路徑');
            return false
        }
    }
    return true
}

async function openCrawlerWeb() {

    if (!checkDriver()) {// 檢查Driver是否是設定,如果無法設定就結束程式
        return
    }

    // 建立這個broswer的類型
    let driver = await new webdriver.Builder().forBrowser("chrome").build();
    const web = 'https://www.google.com/';//填寫你想要前往的網站
    driver.get(web)//透國這個driver打開網頁
}
openCrawlerWeb()//打開爬蟲網頁
ℹ️ 專案原始碼
- 今天的完整程式碼可以在這裡找到喔
- 我也貼心地把昨天的把昨天的程式碼打包成壓縮檔,你可以用裡面乾淨的環境來實作今天的功能喔
- 請記得在終端機下指令 yarn 才會把之前的套件安裝
- windows需下載與你chrome版本相同的chrome driver放在專案根目錄
參考資源
- [JS] 談談 JavaScript 中的錯誤處理 Error Handling
- 為什麼用 (或不用) Puppeteer
- 重新認識 JavaScript: Day 26 同步與非同步
- 鐵人賽:JavaScript Await 與 Async
免責聲明:文章技術僅抓取公開數據作爲研究,任何組織和個人不得以此技術盜取他人智慧財產、造成網站損害,否則一切后果由該組織或個人承擔。作者不承擔任何法律及連帶責任!
在許多人的幫助下,本系列文章已出版成書,並添加了新的篇章與細節補充:
- 加入更多實務經驗,用完整的開發流程讓讀者了解專案每個階段要注意的事項
- 將爬蟲的步驟與技巧做更詳細的說明,讓讀者可以輕鬆入門
- 調整專案架構
- 優化爬蟲程式,以更廣的視角來擷取網頁資訊
- 增加資料驗證、錯誤通知等功能,讓爬蟲執行遇到問題時可以第一時間通知使用者
- 排程部分改用 node-schedule & pm2 的組合,讓讀者可以輕鬆管理專案程序並獲得更精確的 log 資訊
有興趣的朋友可以到天瓏書局選購,感謝大家的支持。

留言載入中…