【Day16】不藏私,加上5行程式就能優化爬蟲的小技巧 & 學會爬蟲,之後呢?

這篇文章寫於 2020 年,文中的工具與版本可能已經更新,實作時請以官方文件為準。
本文目錄
當技術為你的生活帶來便利,他才有存在的意義
為什麼寫這篇文章
- 如果你跟著這幾天的教學走還是遇到一些莫名其妙的問題,希望在今天的文章有得到你想要的解答
- 這幾天所教的技巧足以讓你爬下絕大多數的網頁資訊了,學習爬蟲只是一個過程,我們的目標是希望能靠這些數據給我們帶來便利,所以今天也分享一些思路給大家
今日目標
1. 優化爬蟲
1.1 優化分成哪些面向?
1.2 優化執行效率及穩定度
1.3 背景執行並減少記憶體的消耗
2. 學會爬蟲,之後呢?
1. 優化爬蟲
昨天我們已經完成爬蟲所需要的功能了,下一步要思考的是如何優化
1.1 優化分成哪些面向?
前面【Day13】refactor-重構程式碼,讓合作夥伴對你比讚在討論如何讓你在開發上更有效率,原則上不影響輸出的結果;而今天討論的優化是一個多面向的問題,我把他區分成顯性及隱性兩種:
- 顯性:使用者肉眼可見
- 改善使用者操作流程、介面
- 程式執行過程的畫面優化
- 隱性:使用者覺得自己的電腦變順了(不過他們通常不會聯想到是程式優化了)
- 更好地執行效率
- 使用更少的記憶體
- 執行的穩定性
優化是一條沒有盡頭的路,上面我只是提了幾個常見要注意的點而已,接下來我們就來實際優化現在的爬蟲吧~
1.2 優化執行效率及穩定度
-
遇到的問題
- 在 driver.wait 加上等待時間後偶爾還是會出現登入失敗或是抓不到追蹤人數的問題
- 在爬蟲的時候會影響到我看 youtube 的流暢程度
-
判斷造成的原因
- 本身的網路速度太慢,造成網頁過了 driver.wait 的等待時間後依舊還沒完成載入
- FB、IG 粉專都是充滿圖片的頁面,載入這些資源時消耗太多流量
-
優化的方式
因為本專案爬蟲所分析的內容都跟圖片無關,所以只要不載入這些資源就有以下好處:- 減少瀏覽器使用流量
- 減少瀏覽器載入時間
想要知道如何不載入圖片,你可以在 Google 搜尋 selenium chrome參數 ,有很多熱心的大神已經幫你整理好常用的參數了
-
打開 initDrive.js 在 chrome 的 option 加入不載入圖片的參數
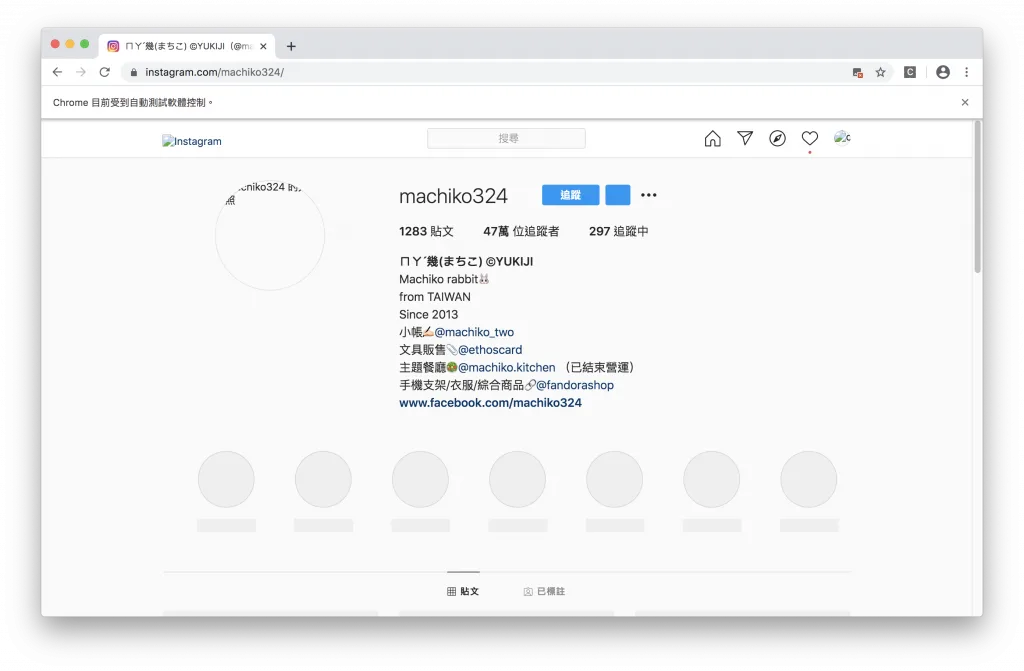
options.addArguments('blink-settings=imagesEnabled=false')//不加載圖片提高效率加上這段程式後,在專案資料夾的終端機(Terminal)執行指令 yarn start ,便可以很明顯的感受到網頁載入速度變快很多,並且所有圖片都沒有載入(下圖)
1.3 背景執行並減少記憶體的消耗
- 遇到的問題
- 有時爬蟲執行到一半手賤點一下爬蟲瀏覽器導致程式拋出例外
- 爬蟲執行時候的畫面一直閃好煩
- 在記憶體 8G 的電腦執行爬蟲時覺得電腦變得很頓
- 判斷造成的原因
- 人有時控制不住自己的手
- 執行爬蟲時干擾到使用者的日常工作
- chrome 吃太多記憶體
- 優化的方式
在爬蟲每個步驟及功能都穩定後,其實不需跳出瀏覽器視窗來觀察他的動作,讓瀏覽器在背景執行不但不會干擾使用者工作更能減少記憶體的浪費-
打開 initDrive.js 並在 chrome 的 option 加入不打開瀏覽器視窗的參數如下
options.addArguments('--headless')//瀏覽器不提供頁面觀看,linux下如果系統是純文字介面不加這條會啓動失敗
options.addArguments('--log-level=3')//這個option可以讓你跟headless時網頁端的console.log說掰掰

//下面參數能提升爬蟲穩定性
options.addArguments('--disable-dev-shm-usage')//使用共享內存RAM
options.addArguments('--disable-gpu')//規避部分chrome gpu bug
設定完這些後,在專案資料夾的終端機(Terminal)執行指令 yarn start ,就會發現爬蟲變成背景執行,並且電腦順暢許多
-
2. 學會爬蟲,之後呢?
原本我打算用兩天的文章來教取得當日貼文數量的方法,但文章寫完後就刪掉了,因為讀者完全有能力用這幾天所教的技術自行實踐這項功能;我希望用這30天分享更多不同的技術及有幫助的觀念
授人以魚不如授人以漁
使用模擬瀏覽器來爬蟲我認為是最符合初學者的,你不用去分析複雜的 api,去猜裡面的參數是甚麼意義
你需要做的只是把你平常操作的流程用程式的方式來替你做一遍,然後抓取你所需要的資訊
我寫的文章只是爬蟲的技巧的冰山一角,但只要有了開頭以及研究的方向我相信你是有能力獨立完成其他網頁的爬蟲
現在人工智慧流行,大數據當道,爬蟲是取得大數據的方法之一,你能透過這些數據分析的東西太多了,我在這裡簡單舉例:
- 追蹤人數爆減/爆增
- 是因為某一篇貼文引起的嗎?
- 當天是否有媒體新聞的報導?
- 粉專經營者是否有特殊決策?
- 發文頻率與追蹤人數的關係
- 發文頻率是否與追蹤人數成長正相關
- 怎麼樣的發文頻率是最恰當的
- 不同行業的發文頻率比較
- 貼文按讚與回應
- 什麼樣的貼文會獲得最多迴響
- 獲得最多讚的貼文有什麼共同特徵
隨便舉的例子都能獨立出來都能成為一篇論文或是商品,爬蟲是一個很強的武器,但這把武器的強度要看使用者如何發揮他,我想會看這系列教學文章的讀者心中都有想要爬蟲的目標,開始動手實作吧!
再次提醒,技術沒有善惡,人的使用方式才會有善惡,希望這份技術可以幫大家節省時間以及避免重工;如果你把它拿來盜取智慧財產、個人檔案及機敏資訊請自行負擔後續法律責任
筆者碎碎念
我希望看完文章的讀者能夠吸收到問題思考的方式,不要只是單純的 copy & paste ,這樣對技術長期來講是在累積負債
如果你是程式的新手,你可以透過修改一些參數來看看結果會有什麼樣的變化,少加哪些參數是不是真的會有錯誤
不要害怕犯錯,因為學習程式的路上幾乎不存在一條完美的道路
你現在滿意的程式往往在幾個月後你會覺得當時怎麼寫的這麼爛
當你誕生出這個想法的時候就是成長了
⏭️ 下個階段
關於使用網頁爬蟲的技術文章就分享到今天,接下來我們要來研究 爬蟲資料如何儲存 ,敬請期待
ℹ️ 專案原始碼
- 今天的完整程式碼可以在這裡找到喔
- 我也貼心地把昨天的把昨天的程式碼打包成壓縮檔,你可以用裡面乾淨的環境來實作今天json改寫的部分喔
- 請記得在終端機下指令 yarn 才會把之前的套件安裝
- windows需下載與你chrome版本相同的chrome driver放在專案根目錄
- 調整.env檔
- 填上FB登入資訊
- 填上FB版本(classic/new)
- 填上IG登入資訊
- 調整fanspages資料夾內目標爬蟲的粉專網址
參考資源
免責聲明:文章技術僅抓取公開數據作爲研究,任何組織和個人不得以此技術盜取他人智慧財產、造成網站損害,否則一切后果由該組織或個人承擔。作者不承擔任何法律及連帶責任!
在許多人的幫助下,本系列文章已出版成書,並添加了新的篇章與細節補充:
- 加入更多實務經驗,用完整的開發流程讓讀者了解專案每個階段要注意的事項
- 將爬蟲的步驟與技巧做更詳細的說明,讓讀者可以輕鬆入門
- 調整專案架構
- 優化爬蟲程式,以更廣的視角來擷取網頁資訊
- 增加資料驗證、錯誤通知等功能,讓爬蟲執行遇到問題時可以第一時間通知使用者
- 排程部分改用 node-schedule & pm2 的組合,讓讀者可以輕鬆管理專案程序並獲得更精確的 log 資訊
有興趣的朋友可以到天瓏書局選購,感謝大家的支持。

留言載入中…