【Day9】爬蟲第一步,FB先登入

這篇文章寫於 2020 年,文中的工具與版本可能已經更新,實作時請以官方文件為準。
本文目錄
⚠️ 在爬蟲前請注意這些事情避免違法
- 請勿拿來蒐集個人隱私
- 相片、個人資料
- 請勿高頻率訪問一個網站
- 高頻率訪問一個網站可能對導致對方伺服器癱瘓(DDOS)
- 請勿盜取相關智慧財產權相關的資料
- 社群上發表的文章、有人統整過的資訊
- 請勿蒐集網站後台資料
- 僅抓取前端網頁有顯示的公開信息,不要去抓後台的敏感資訊
- 請勿作為破解工具
- 嘗試各種帳號密碼試圖登入自己沒有權限的頁面
這系列的教學文章是想讓大家省去如同機器人般的操作,把時間精力放在分析資料上面
今天的學習要特別注意什麼?
一定要自己實作過一遍!
一定要自己實作過一遍!
一定要自己實作過一遍!
因為很重要所以要說三遍,前面幾篇文章比較偏向概念,但今後的文章概念實作並重;因為FB 與 IG 改版的速度極快,我現在提供的方法在他們改版後可能就會失效,所以文章的每個步驟要自己去實作才能理解為什麼這樣做,同時培養自己分析網頁結構的能力
今日目標
1. 學會分析網頁結構 - 以Facebook登入頁為範例
1.1 拆解平常登入 FB 的步驟
1.2 將平常操作的位置轉化為程式可以讀懂的路徑(Xpath)
2. 打造自動登入FaceBook的機器人
2.1 了解 selenium-webdriver 如何操作網頁元件
2.2 在 .env檔填上 FB 登入資訊,並從程式中讀取
2.3 讓爬蟲幫你完成平日登入的步驟
1. 學會分析網頁結構 — 以Facebook登入頁為範例
你可以想像 selenium-webdriver 這個套件就是讓機器人代替你的手來做操作,想要讓機器幫你操作,你需要告訴他明確的操作位置,接下來向大家介紹如何抓出這些位置
1.1 拆解平常登入FB的步驟
-
先用 chrome 無痕模式打開Facebook登入頁面
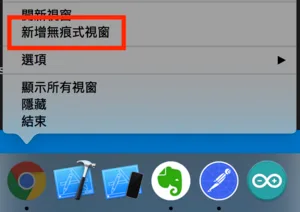
-
打開後的 FB 的登入畫面如下
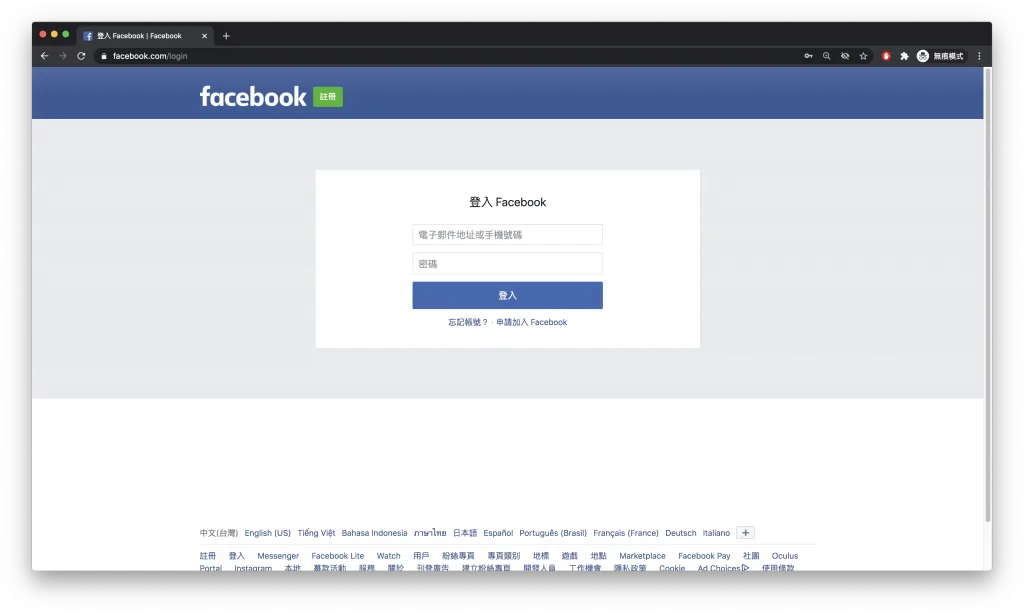
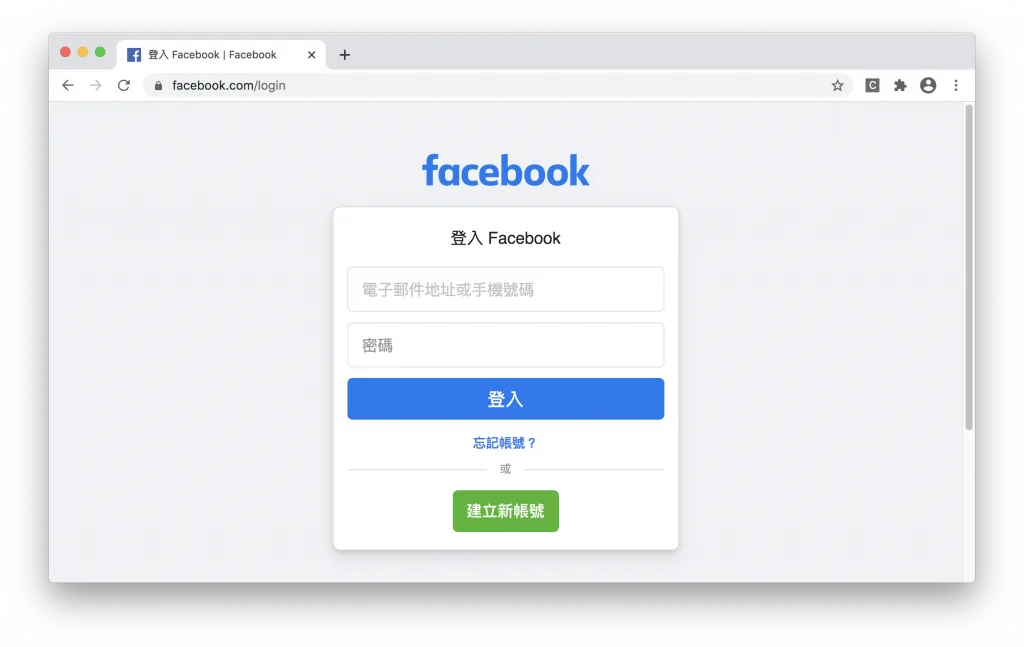
剛發完文章發現 FB 登入畫面又變惹QQ,不過操作上都一樣請勿驚慌
-
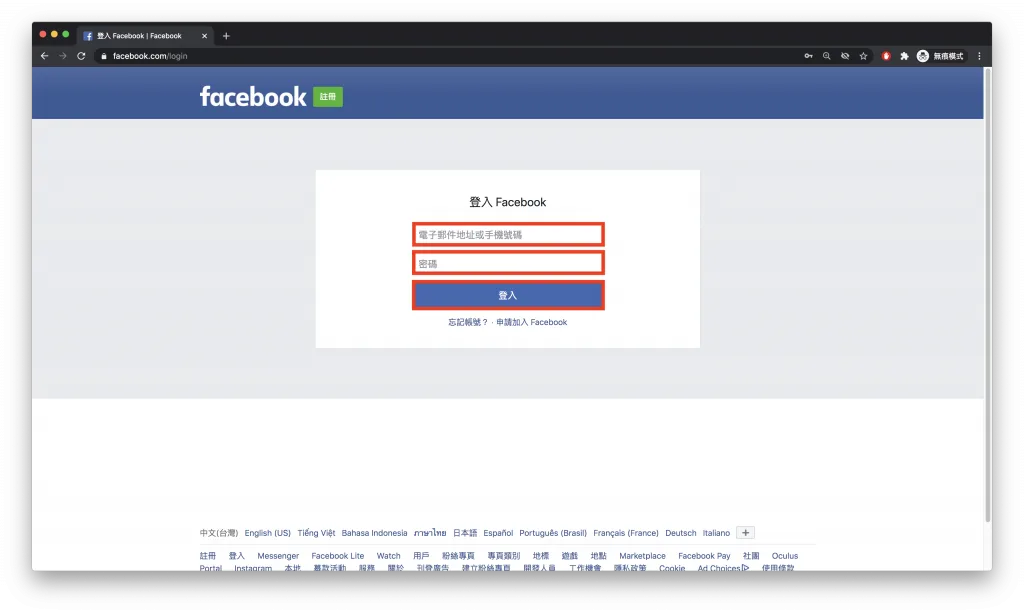
接下來把你平常登入FB的動作分幾個步驟,下一步要對這些操作到的元件進行結構分析:
- 輸入電子郵件或電話
- 輸入密碼
- 按下登入按鈕
1.2 將平常操作的位置轉化為程式可以讀懂的路徑(Xpath)
-
我們先用先紅框圈出登入會用到的元件位置
-
接著對元件按下滑鼠右鍵 → 檢查,就會進入開發者的介面
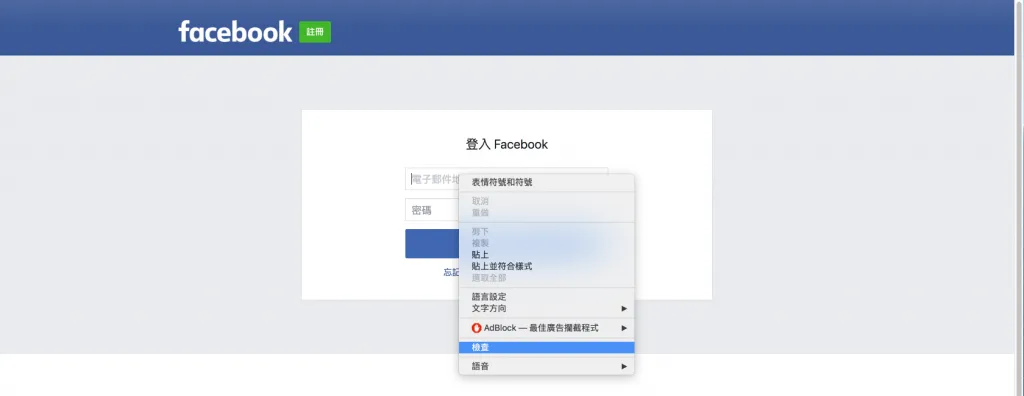
-
然後你就會看到一堆不友善的程式碼,這個時候別緊張,我們原則上不需要理解他們在寫什麼,我們只要知他在什麼位置就好
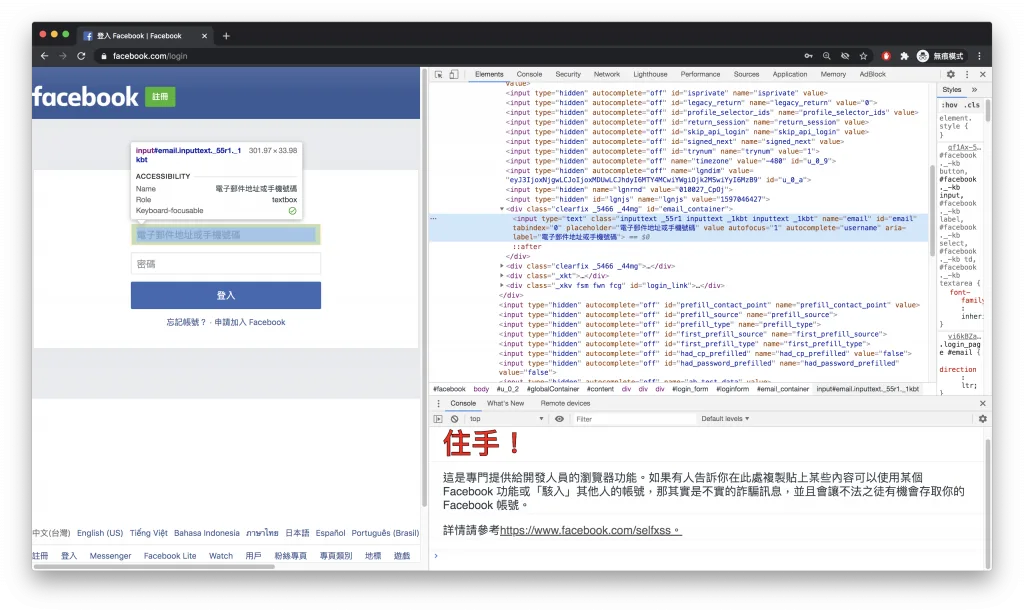
-
想知道他位置的方法也很簡單,對開發者頁面的那個程式碼按右鍵 → Copy → Copy Xpath
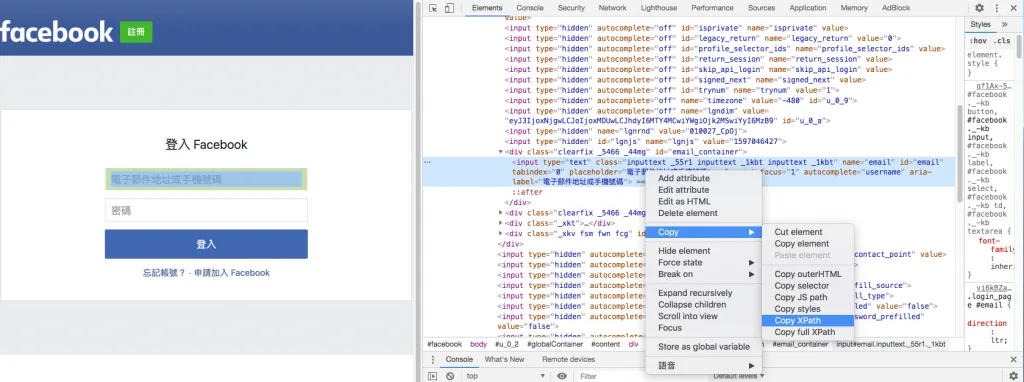
你就會得到 電子郵件或電話 元件在這個頁面的位置
//*[@id="email"]重複上面的步驟你面可以取得 密碼 元件的位置
//*[@id="pass"]以及 登入按鈕 元件的位置
//*[@id="loginbutton"]取得這三個元件的 Xpath 後我們便可以明確告訴機器人該做什麼事嚕
2. 打造自動登入FaceBook的機器人
2.1 了解 selenium-webdriver 如何操作網頁元件
-
透過網頁的 Xpath 取出元件
// 取出想操作的元件 = 瀏覽器會等待直到路徑(//*[@id="email"])的元件顯示才回傳該元件 const fb_email_ele = await driver.wait(until.elementLocated(By.xpath(`//*[@id="email"]`))); -
在輸入框中輸入指定文字
// 將你想要輸入的文字透過sendKeys塞入元件 fb_email_ele.sendKeys(fb_username) -
點擊按鈕
// 將取出的元件使用click函式觸發點擊事件
login_elem.click()
2.2 在 .env檔填上 FB 登入資訊,並從程式中讀取
理解關鍵程式的功能後我們來把他們組合起來吧:
-
在 .env檔填寫 FB 登入的帳號密碼
#填寫自己登入FB的真實資訊(建議開小帳號來實驗,因為帳號使用太頻繁會被官方鎖住) FB_USERNAME='fb username' FB_PASSWORD='fb password' -
取出在 .env檔案裡面的 FB 帳號密碼提供主程式使用
require('dotenv').config(); //載入.env環境檔

//取出.env檔案填寫的FB資訊
const fb_username = process.env.FB_USERNAME
const fb_userpass = process.env.FB_PASSWORD
2.3 讓爬蟲幫你完成平日登入的步驟
-
將套件中會使用到的函式引入
const webdriver = require('selenium-webdriver'), // 加入虛擬網頁套件 By = webdriver.By,//你想要透過什麼方式來抓取元件,通常使用xpath、css until = webdriver.until;//直到抓到元件才進入下一步(可設定等待時間) const chrome = require('selenium-webdriver/chrome'); const path = require('path');//用於處理文件路徑的小工具 const fs = require("fs");//讀取檔案用 -
將我們對網頁操作的操作加入程式
- 前往 facebook 登入頁面 → 輸入登入資訊 → 按下登入按鈕
async function loginFacebook () {

    if (!checkDriver()) {
        return
    }

    let driver = await new webdriver.Builder().forBrowser("chrome").build();
    const web = 'https://www.facebook.com/login';//我們要前往FB
    await driver.get(web)//在這裡要用await確保打開完網頁後才能繼續動作

    //填入fb登入資訊
    //使用until是要求直到網頁顯示了這個元件才能執行下一步
    const fb_email_ele = await driver.
        wait(until.elementLocated(By.xpath(`//*[@id="email"]`)));//找出填寫email的元件
    fb_email_ele.sendKeys(fb_username)//將使用者的資訊填入

    const fb_pass_ele = await driver.
        wait(until.elementLocated(By.xpath(`//*[@id="pass"]`)));
    fb_pass_ele.sendKeys(fb_userpass)

    //抓到登入按鈕然後點擊
    const login_elem = await driver.
        wait(until.elementLocated(By.xpath(`//*[@id="loginbutton"]`)))
    login_elem.click()
}
loginFacebook()//登入FB
執行程式
在專案資料夾的終端機(Terminal)執行指令
yarn start
你會看到 chrome 的應用程式自動打開並且成功登入 Facebook
如果模擬器讓你成功登入 FB 可以在下方留言讓我知道喔,登入成功的瞬間有沒有充滿成就感呢?
ℹ️ 專案原始碼
- 今天的完整程式碼可以在這裡找到喔
- 我也貼心地把昨天的把昨天的程式碼打包成壓縮檔,你可以用裡面乾淨的環境來實作今天的功能喔
- 請記得在終端機下指令 yarn 才會把之前的套件安裝
- windows需下載與你chrome版本相同的chrome driver放在專案根目錄
- 調整你.env檔填上FB登入資訊
參考資源
免責聲明:文章技術僅抓取公開數據作爲研究,任何組織和個人不得以此技術盜取他人智慧財產、造成網站損害,否則一切后果由該組織或個人承擔。作者不承擔任何法律及連帶責任!
在許多人的幫助下,本系列文章已出版成書,並添加了新的篇章與細節補充:
- 加入更多實務經驗,用完整的開發流程讓讀者了解專案每個階段要注意的事項
- 將爬蟲的步驟與技巧做更詳細的說明,讓讀者可以輕鬆入門
- 調整專案架構
- 優化爬蟲程式,以更廣的視角來擷取網頁資訊
- 增加資料驗證、錯誤通知等功能,讓爬蟲執行遇到問題時可以第一時間通知使用者
- 排程部分改用 node-schedule & pm2 的組合,讓讀者可以輕鬆管理專案程序並獲得更精確的 log 資訊
有興趣的朋友可以到天瓏書局選購,感謝大家的支持。

留言載入中…