MySQL Master Slave Replication 主從式架構設定教學

這篇文章寫於 2021 年,文中的工具與版本可能已經更新,實作時請以官方文件為準。
本文目錄
- 一、30 秒認識 Master Slave Replication 是什麼
- 為什麼需要 Master Slave Replication 的架構?
- Master Slave Replication 為什麼能夠解決這些問題?
- Master Slave Replication 的架構
- 二、實作 MySQL Master Slave replication
- 前置作業
- 準備兩台 ubuntu server (自己實驗建議使用 VMWARE),筆者環境配置如下
- 給兩台 sever 安裝 MySQL
- 建立MySQL Replication
- Master server 設定
- Slave server 設定
- STEP 2:設定 Slave server 的 my.cnf
- 三、驗證 Master、Slave DB 是否同步
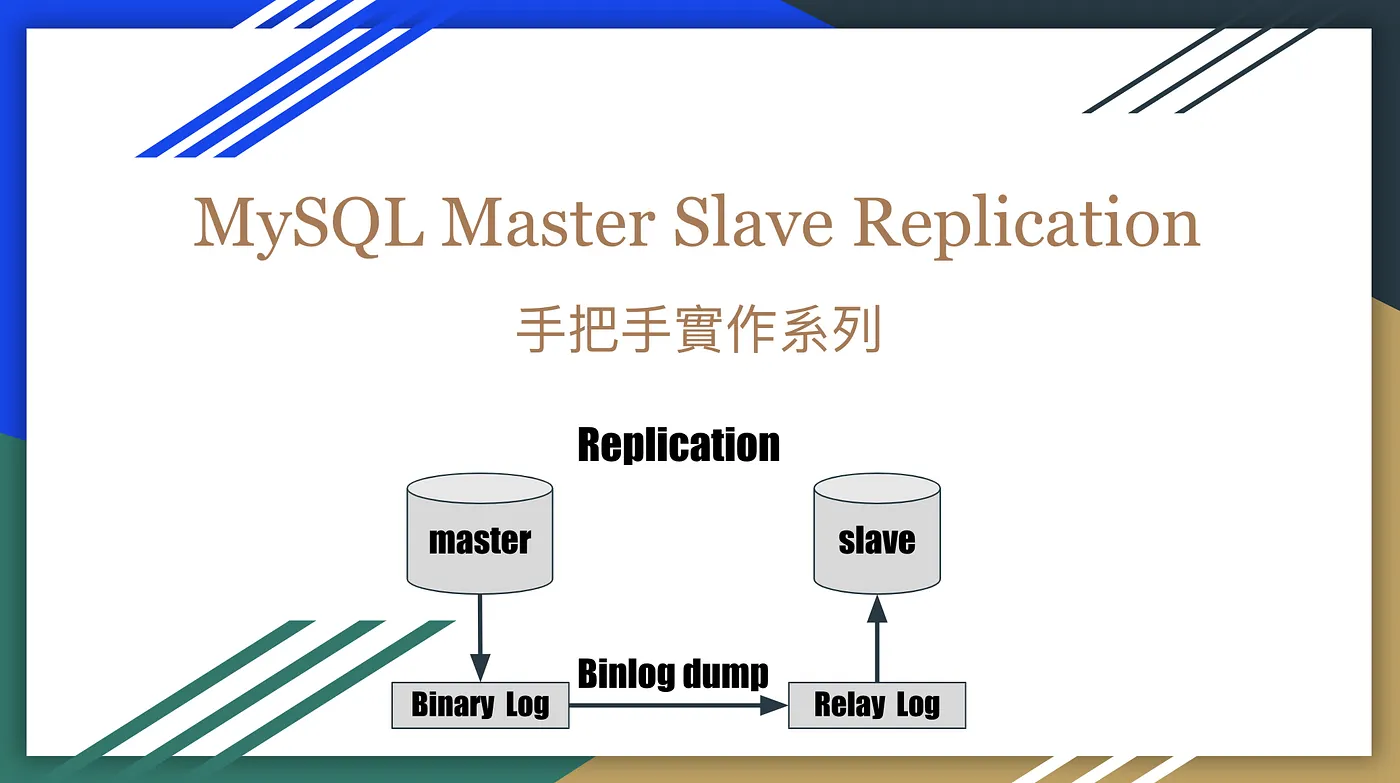
Master Slave Replication 是一個 Web 工程師需要具備的基礎概念,我們可以透過這個技術有效的降低 Database server 負荷,同時給使用者提供更穩定順暢的體驗;本文除了讓你了解這個技術的原理外還會以 MySQL 這門資料庫語言一步步透過實作讓你理解如何實現它。
一、30 秒認識 Master Slave Replication 是什麼
  ∙ 為什麼需要 Master Slave Replication 的架構?
  ∙ Master Slave Replication 為什麼能夠解決這些問題?
  ∙ Master Slave Replication 的架構
二、實作 MySQL Master Slave replication
  ∙ 前置作業
  ∙ 建立MySQL Replication
三、驗證 Master、Slave DB 是否同步
一、30 秒認識 Master Slave Replication 是什麼
為什麼需要 Master Slave Replication 的架構?
- 網站需要面對大流量:新聞媒體類的網站無論哪個時段都會被大量的檢索,如果資料庫只用一個 server 來處理會無法負荷瞬間的高流量。
- 資料庫內容需要被分析:公司如果有資料分析部門,他們也會隨時監控資料庫的變化來產生報表,但如果跟一般使用者一樣 query 同一台 server 會使這台 server 增加不必要的負荷導致使用者體驗下降。
Master Slave Replication 為什麼能夠解決這些問題?
- 主從式架構:將資料庫的 server 區分成 Master(1台) 與 Slave(N台) 兩種,Master 負責資料寫入,Slave 提供資料檢索;這樣就把壓力分散到幾台 Server 上面。
- 資料庫同步:Slave 會同步 Master 的資料,這樣除了分散 server 壓力外,資料也獲得了備份。
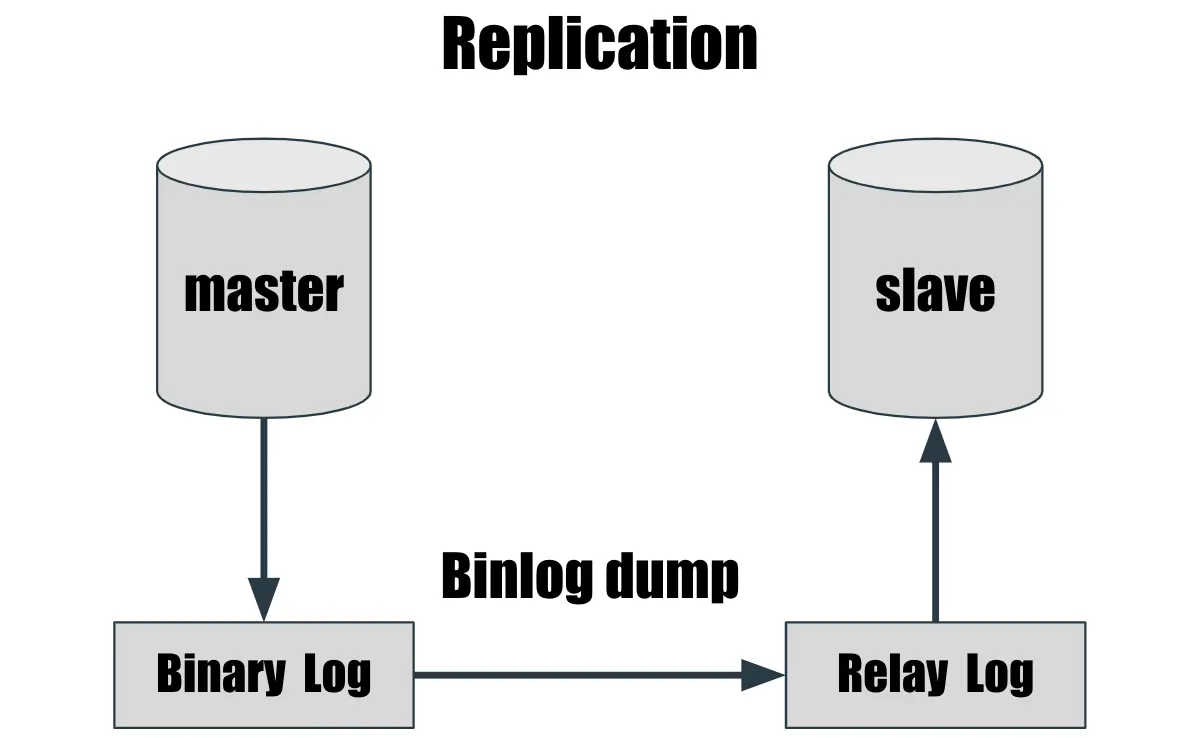
Master Slave Replication 的架構
- 在 master 的 server 執行的 SQL command 會被記錄在 Binary Log 裡面
- master 將 Binary Log 傳送到 slave 的 Relay Log
- slave 依據 Relay Log 做資料的變更
二、實作 MySQL Master Slave replication
前置作業
準備兩台 ubuntu server (自己實驗建議使用 VMWARE),筆者環境配置如下
硬體配置一定會影響到效能,筆者只是建置一個提供實驗的環境而已
- OS version:ubuntu 16.04
- RAM:1G
- ROM:8G
給兩台 sever 安裝 MySQL
安裝指令如下
sudo apt update
sudo apt install mysql-server
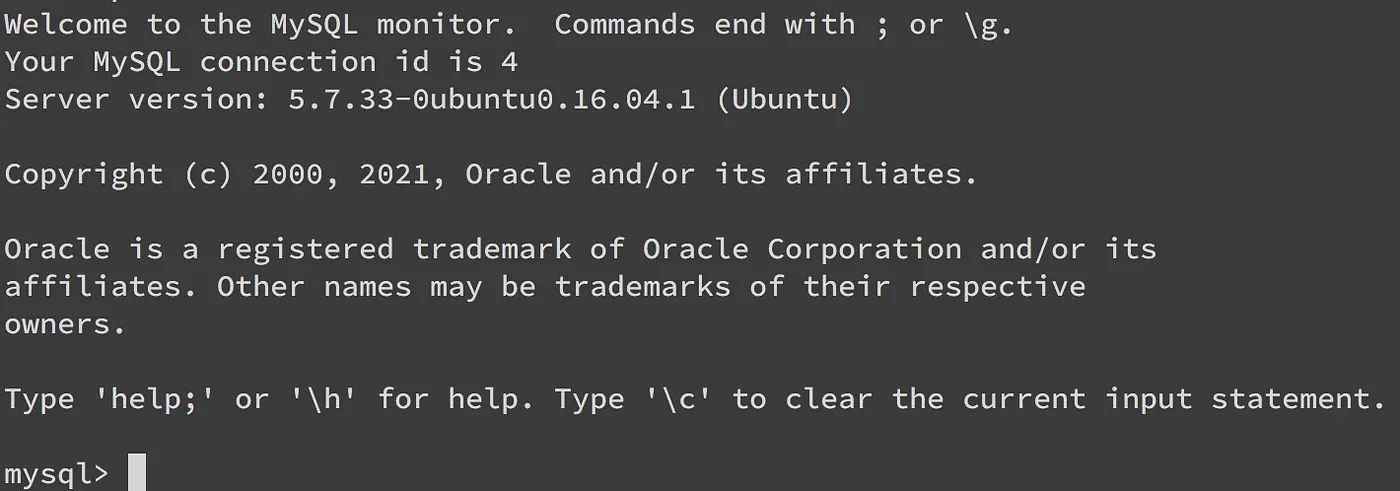
安裝完成後你可以先登入 MySQL 看看安裝版本資訊
sudo mysql -u root -p
建立MySQL Replication
Master server 設定
STEP 1:設定 Master server 的 my.cnf
sudo vi /etc/mysql/my.cnf
[mysqld]
# 在這裡設定已蓋過預設的127.0.0.1(只能連本機)
bind-address = 0.0.0.0

# id為唯一值,每個server不可重覆
server-id = 1

# 指定產生bin log檔案名稱,使MySQL記錄所有DB交易記錄
log-bin=mysql-bin
原始碼:my.cnf(GitHub Gist)
儲存後,重啟 MySQL 才會生效
sudo /etc/init.d/mysql restart
STEP 2:在 Master server 建立給 Slave 複製資料的帳號
登入 MySQL
sudo mysql -u root -p
建立有 REPLICATION、SLAVE 權限的 user 帳號
/*建立使用者*/
mysql> CREATE USER 'account'@'ip' IDENTIFIED BY 'password';
/*給使用者權限*/
mysql> GRANT REPLICATION SLAVE ON *.* TO 'account'@'ip';
/*使權限生效*/
mysql> FLUSH PRIVILEGES;
原始碼:create_slave_user.sql(GitHub Gist)
STEP 3:備份 Master server 的 DB
執行此步驟時如果系統已經上線,一定要發出公告說明系統維護時間
在完成 DB Replication 前,為了保證 Master 與 Slave 的資料相同,你需要先把 DB Lock 成 read only:
mysql> FLUSH TABLES WITH READ LOCK;
備份指令:
mysqldump -uroot -p --all-databases > master.sql
解除 read only:
mysql> UNLOCK TABLES;
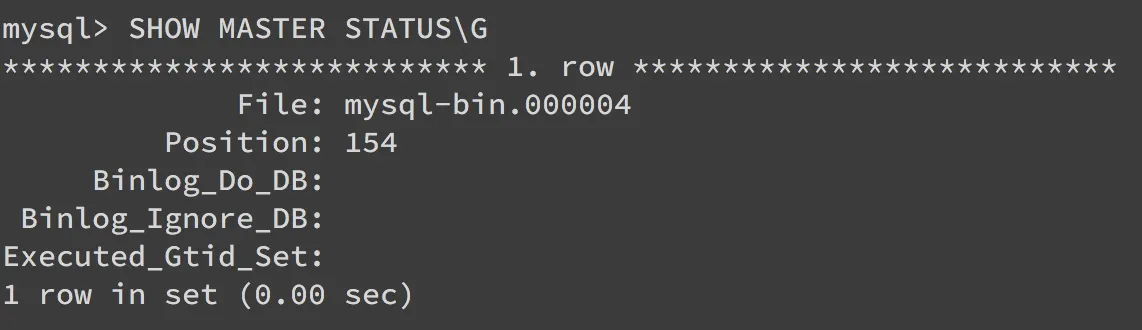
STEP 4:檢查 Master 是否已經啟動
mysql> SHOW MASTER STATUS \G
Slave server 設定
STEP 1:將剛剛備份的 master.sql 還原到 Slave server 的 DB
先複製 master.sql 到 Slave server 的目錄下
sudo scp master.sql <username>@<IP or hostname>:<Destination>
下指令還原 DB
mysql -u root -p — default-character-set=utf8 < master.sql
STEP 2:設定 Slave server 的 my.cnf
sudo vi /etc/mysql/my.cnf
[mysqld]
#注意:不可與剛剛設定的 Master 重複
server-id=2

#Slave server 的 DB 開啟唯獨避免被寫入
read-only=on
原始碼:slave_my.cnf(GitHub Gist)
儲存後,重啟 MySQL 才會生效
sudo /etc/init.d/mysql restart
STEP 3:設定 SlaveDB,指定 Master DB 登入資訊,並啟動 Replication
/* 這裡的帳號密碼就上面 Master 設定的那組 */
mysql> CHANGE MASTER TO MASTER_HOST='master_ip',
              MASTER_USER='account',
              MASTER_PASSWORD='password';
原始碼:setting_slave_info.sql(GitHub Gist)
啟動 Slave Replication:
mysql> START SLAVE;
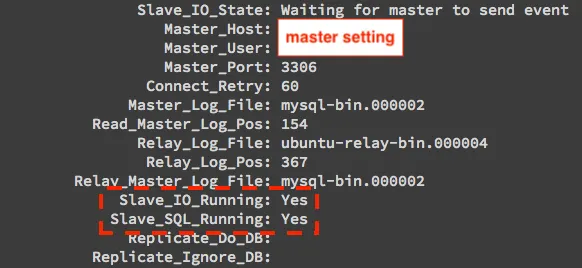
STEP 4:檢查 replication 狀態
SHOW SLAVE STATUS \G
如果下圖紅框皆顯示 Yes 就代表你成功嚕!
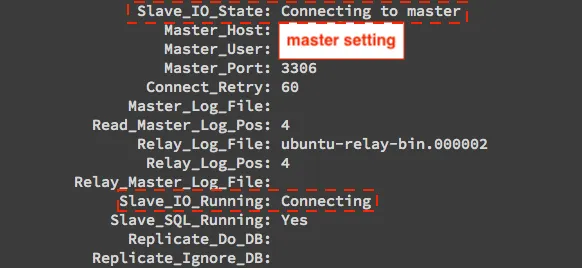
如果你看到下面這個畫面,可能是因為你的 Master MySQL 的設定有問題,最有可能是『使用者帳號、密碼錯誤』、『bind-address 沒有調整』
三、驗證 Master、Slave DB 是否同步
先在 Master 確認是不是真的有跟 Slave 串接成功
show slave hosts;
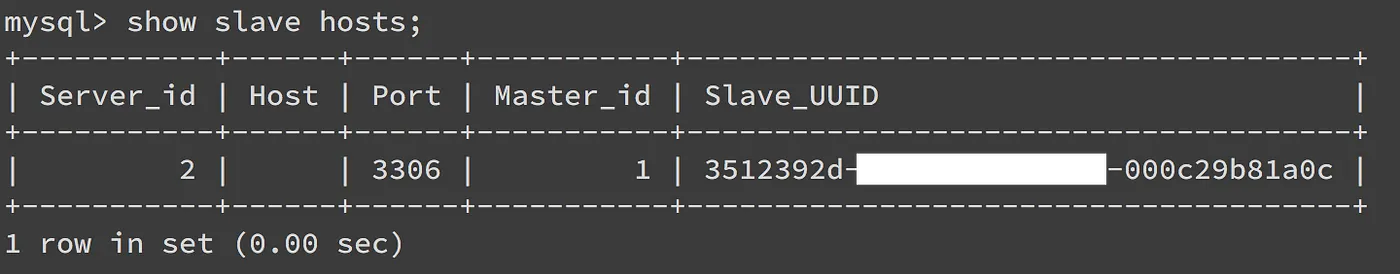
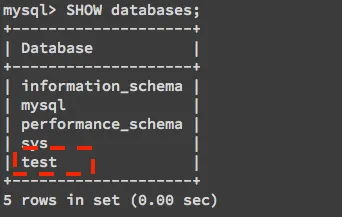
確認連接成功後我們在 Master server 上面新增一個 DB
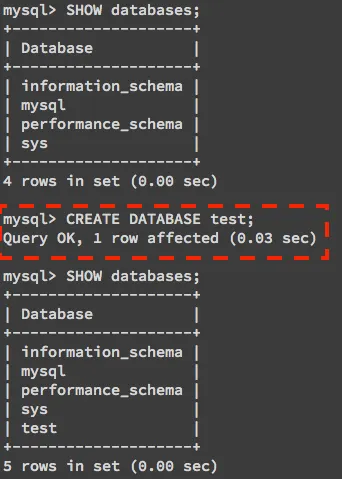
回到 Slave server 就會看到 DB 被同步過來嚕~
這篇文章是針對 MySQL Master Slave Replication 做說明,但你依照上面的做法完成後還需要思考幾個問題:
- 我們知道 Master server 是用來更新資料,Slave server 是用來檢索資料;但他們都是獨立的 ip,總不能每個 api 執行時都連不一樣的 ip 吧?
- Slave 的資料是從 Master 上複製過來的,會複製就代表會有延遲,要如何保持資料的一致性呢?
如果你想深入了解上面的問題如何解決可以參考我的文章:
👍 在 MySQL 5.7 解決主從複製的延遲問題
👍 Ubuntu 用 Atlas 實現 MySQL Proxy 讀寫分離 read/write splitting

留言載入中…