手把手帶你建立 Node.js 專案 & Kafka 環境,透過實作了解 Kafka 的運行邏輯
本篇文章將會帶大家一步步建立 Node.js 專案 & Kafka 環境,透過具體實踐來了解 Kafka 的運行邏輯。

本文目錄
在上篇文章中,筆者帶大家了解 Kafka 這門技術的使用情境、優點,以及它具體是如何解決問題的。
而本篇文章將會帶大家一步步建立 Node.js 專案 & Kafka 環境,透過具體實踐來了解 Kafka 的運行邏輯。
大綱

ㄧ、手把手帶你建立 Node.js 專案 & Kafka 環境
二、啟動專案,了解 Kafka 的運行邏輯
  ➤ 1 個 Producer VS 1 個 Consumer
  ➤ Kafka 持久化驗證
  ➤ 1 個 Partition 的數據只允許 Consumer Group 中的某個 Consumer 消費
  ➤ 2 個 Partition VS 2 個 Consumer
ㄧ、手把手帶你建立 Node.js 專案 & Kafka 環境
上一篇文章講了這麼多理論,下面就建立一個 Node.js 專案,來實際了解 Kafka 的運作邏輯吧!
如果懶得按照步驟執行,可以直接到筆者的 Github Clone 一份下來。
筆者 local 的 Node.js 版本為 v18.12.0。
SETP 1:建立專案、安裝 kafkajs 套件。
npm init -f
npm install --save kafkajs
SETP 2:建立儲存 Kafka 數據的資料夾(這是下一步「docker-compose.yml」裏面「volumes」的路徑)
mkdir -p deploy/kafkaCluster/kraft
SETP 3:新增「docker-compose.yml」貼上如下程式。
這裡筆者選用不依賴 zookeeper 的 Kafka 版本(KRaft),過去主流會使用 zookeeper 來保存消息,但 Kafka 官方表示在不久後就不再支援 zookeeper,故筆者做此選擇,至於 KRaft 本身有哪些優勢,感興趣的朋友可以參考連結。
version: "3"
services:
  kafka:
    image: 'bitnami/kafka:latest'
    ports:
      - '9092:9092'
    environment:
      - KAFKA_ENABLE_KRAFT=yes
      - KAFKA_CFG_PROCESS_ROLES=broker,controller
      - KAFKA_CFG_CONTROLLER_LISTENER_NAMES=CONTROLLER
      - KAFKA_CFG_LISTENERS=PLAINTEXT://:9092,CONTROLLER://:9093
      - KAFKA_CFG_LISTENER_SECURITY_PROTOCOL_MAP=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT
      - KAFKA_CFG_ADVERTISED_LISTENERS=PLAINTEXT://127.0.0.1:9092
      - KAFKA_BROKER_ID=1
      - KAFKA_CFG_NODE_ID=1
      - KAFKA_CFG_CONTROLLER_QUORUM_VOTERS=1@127.0.0.1:9093
      - ALLOW_PLAINTEXT_LISTENER=yes
    volumes:
        # 這是設定資料要存在哪路的路徑
      - ./deploy/kafkaCluster/kraft:/bitnami/kafka:rw
SETP 4:輸入以下指令把 Kafka 的 Docker 拉下來並執行,你可以把這個 Docker 想像成 Kafka Cluster 中的 Broker。
docker-compose up -d
SETP 5:新增「producer.js」貼上如下程式,我們會透過它每隔 2 秒產生消息到指定的 topic。
const { Kafka, CompressionTypes, logLevel } = require('kafkajs')
const kafka = new Kafka({
  logLevel: logLevel.ERROR,
  brokers: [`localhost:9092`],
  clientId: 'example-producer',
})

const topic = 'topic-test'
const numPartitions = 2;
const crateTopic = async (topic) => {
  const admin = kafka.admin();
  await admin.connect();
  const topics = await admin.listTopics();
  if (!topics.includes(topic)) {
    await admin.createTopics({
      topics: [{
        topic: topic,
        numPartitions: numPartitions
      }],
    })
    const fetchTopicOffsets = await admin.fetchTopicOffsets('topic-test')
    console.log(`Crate topic:${topic} successful!`)
    console.log(fetchTopicOffsets)
  }
  await admin.disconnect();
}

const producer = kafka.producer()
const getRandomNumber = () => Math.round(Math.random(10) * 1000)
const createMessage = (num, partition = 0) => ({
  key: `key-${num}`,
  value: `value-${num}-${new Date().toISOString()}`,
  partition: partition
})

const sendMessage = () => {
  return producer
    .send({
      topic,
      compression: CompressionTypes.GZIP,
      messages: Array(createMessage(getRandomNumber()))
      // 用來測試 kafka 多個 Partition 與 Consumer 的關係
      // messages: Array(createMessage(getRandomNumber(), 0), createMessage(getRandomNumber(), 1))
    })
    .then(console.log)
    .catch(e => console.error(`[example/producer] ${e.message}`, e))
}

const run = async () => {
  await crateTopic(topic);
  await producer.connect()
  setInterval(sendMessage, 2000)
}

run().catch(e => console.error(`[example/producer] ${e.message}`, e))

const errorTypes = ['unhandledRejection', 'uncaughtException']
const signalTraps = ['SIGTERM', 'SIGINT', 'SIGUSR2']
// 收到無法處理錯誤時的處理
errorTypes.forEach(type => {
  process.on(type, async e => {
    try {
      console.log(`process.on ${type}`)
      console.error(e)
      await consumer.disconnect()
      process.exit(0)
    } catch (_) {
      process.exit(1)
    }
  })
})
// 收到中斷訊號時的處理
signalTraps.forEach(type => {
  process.once(type, async () => {
    try {
      await consumer.disconnect()
    } finally {
      process.kill(process.pid, type)
    }
  })
})
SETP 6:新增「consumer.js」貼上如下程式,我們透過它模擬消費者消費特定 topic 的消息。
const { Kafka, logLevel } = require('Kafkajs')
const Kafka = new Kafka({
  logLevel: logLevel.INFO,
  brokers: [`localhost:9092`],
  clientId: 'example-consumer',
})

const topic = 'topic-test'
const consumer = Kafka.consumer({ groupId: 'test-group' })
// 用來測試 Kafka 持久化
// const consumer = Kafka.consumer({ groupId: 'test-group2' })

const run = async () => {
  await consumer.connect()
  await consumer.subscribe({ topic, fromBeginning: true })
  await consumer.run({
    eachMessage: async ({ topic, partition, message }) => {
      const prefix = `${topic}[${partition} | ${message.offset}] / ${message.timestamp}`
      console.log(`- ${prefix} ${message.key}#${message.value}`)
    },
  })
}

run().catch(e => console.error(`[example/consumer] ${e.message}`, e))

const errorTypes = ['unhandledRejection', 'uncaughtException']
const signalTraps = ['SIGTERM', 'SIGINT', 'SIGUSR2']
// 收到無法處理錯誤時的處理
errorTypes.forEach(type => {
  process.on(type, async e => {
    try {
      console.log(`process.on ${type}`)
      console.error(e)
      await consumer.disconnect()
      process.exit(0)
    } catch (_) {
      process.exit(1)
    }
  })
})
// 收到中斷訊號時的處理
signalTraps.forEach(type => {
  process.once(type, async () => {
    try {
      await consumer.disconnect()
    } finally {
      process.kill(process.pid, type)
    }
  })
})
二、啟動專案,了解 Kafka 的運行邏輯
建議使用有分頁功能的終端機(如 iTerm2),這樣比較好觀察與操作。
1 個 Producer VS 1 個 Consumer
在專案根目錄下輸入 node producer.js 模擬「生產者傳送消息」,並在另一個分頁輸入 node consumer.js 模擬「消費者消費消息」。
透過下面的 Gif 大家可以看到消息傳送&消費的過程。
確認消息可以順利生產與消費後,記得透過「Crontrol + C」將程式關閉。
Kafka 持久化驗證
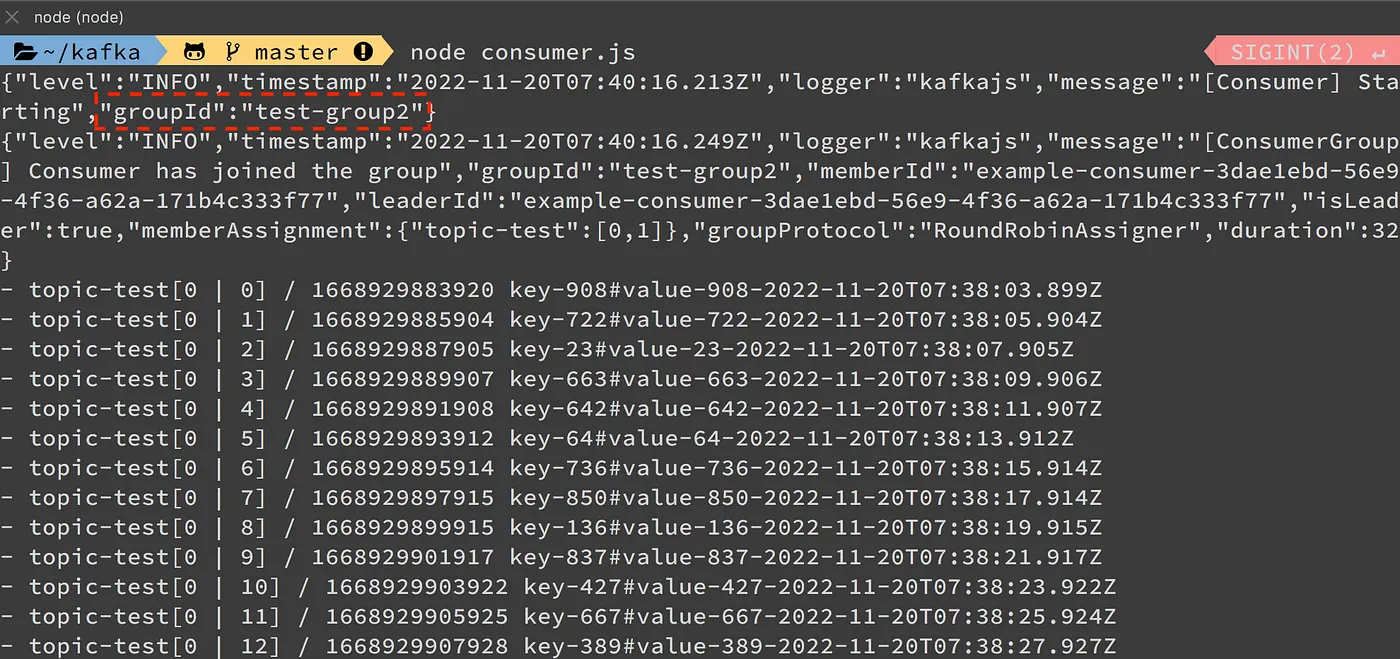
這邊我們再做一個持久化的實驗,我們把「consumer.js」裏面 groupId 的值改為「test-group2」,來確認是否可以重新消費過去的消息。
通過下圖我們可以得知 Kafka 的資料是持久化的,不會因為有消費者消費而消失;因此擴張的時候,只需要增加消費者來處理資料即可。
1 個 Partition 的數據只允許 Consumer Group 中的某個 Consumer 消費
接著我們來驗證,在 Producer 的 Partition 只有 1 個的情境下,是不是相同的 group_id 下只會有一個 consumer 進行消費;這次要開啟 3 個分頁,1 個模擬生產者,2 個模擬消費者。
透過下面的 Gif,大家可以看到在同一個 Consumer Group 中,的確只會有一個 Consumer 進行消費。
2 個 Partition VS 2 個 Consumer
先前有說到 Partition 數量最好與 Consumer 的數量相等,這樣效率才會最高(一個人一個碗);這裡一樣是開啟 3 個分頁,1 個模擬生產者,2 個模擬消費者;同時對「producer.js」裡面的程式做微調如下:
// 將原本的註解
// messages: Array(createMessage(getRandomNumber())),
// 解開下面的註解,測試 Kafka 多個 Partition 與 Consumer 的關係
messages: Array(createMessage(getRandomNumber(),0),createMessage(getRandomNumber(),1)),
透過下面的 Gif,可以觀察到在 2 個 Partition VS 2 個 Consumer 時,消息會均勻的分配。
在文章的最後,筆者想分享一段話:「只透過文字是無法理解一門技術的,需要透過實作才有辦法拼出技術的全貌。」
今天的文章就分享到這裡,筆者之後再找時間分享更深入的組合應用,也歡迎讀者分享自己的使用心得,希望藉助彼此的經驗,讓我們一起在工程師的道路走得更遠。

留言載入中…