透過爬蟲讓 Airtable 管理你的 Medium 文章(補充篇) — 文章字數統計

這篇文章寫於 2021 年,文中的工具與版本可能已經更新,實作時請以官方文件為準。
目前 Medium 只有提供讀者一篇文章的大約閱讀時間資訊,但是對於作者而言他們更想知道自己這篇文章寫了多少字,這樣就能透過 Airtable 知道自己每篇文章/系列的文字產量;今天我們就來分析如何透過爬蟲計算出一篇文章的字數吧。
如果你對這個專案的起源感興趣,請參考:透過爬蟲讓 Airtable 管理你的 Medium 文章(上) — 遇到需求時的分析以及執行步驟
文章大綱:
一、分析 Medium 網頁元素
二、確認爬蟲能正確抓取目標文字
三、設計字數統計的邏輯
四、實測確認可完成文章字數統計
五、未來展望
一、分析 Medium 網頁元素
為了提供爬蟲一個抓取文章的邏輯,我們要先了解 Medium 的網頁元素
STEP 1:按下 F12,了解文章會放在哪一個元素裡面
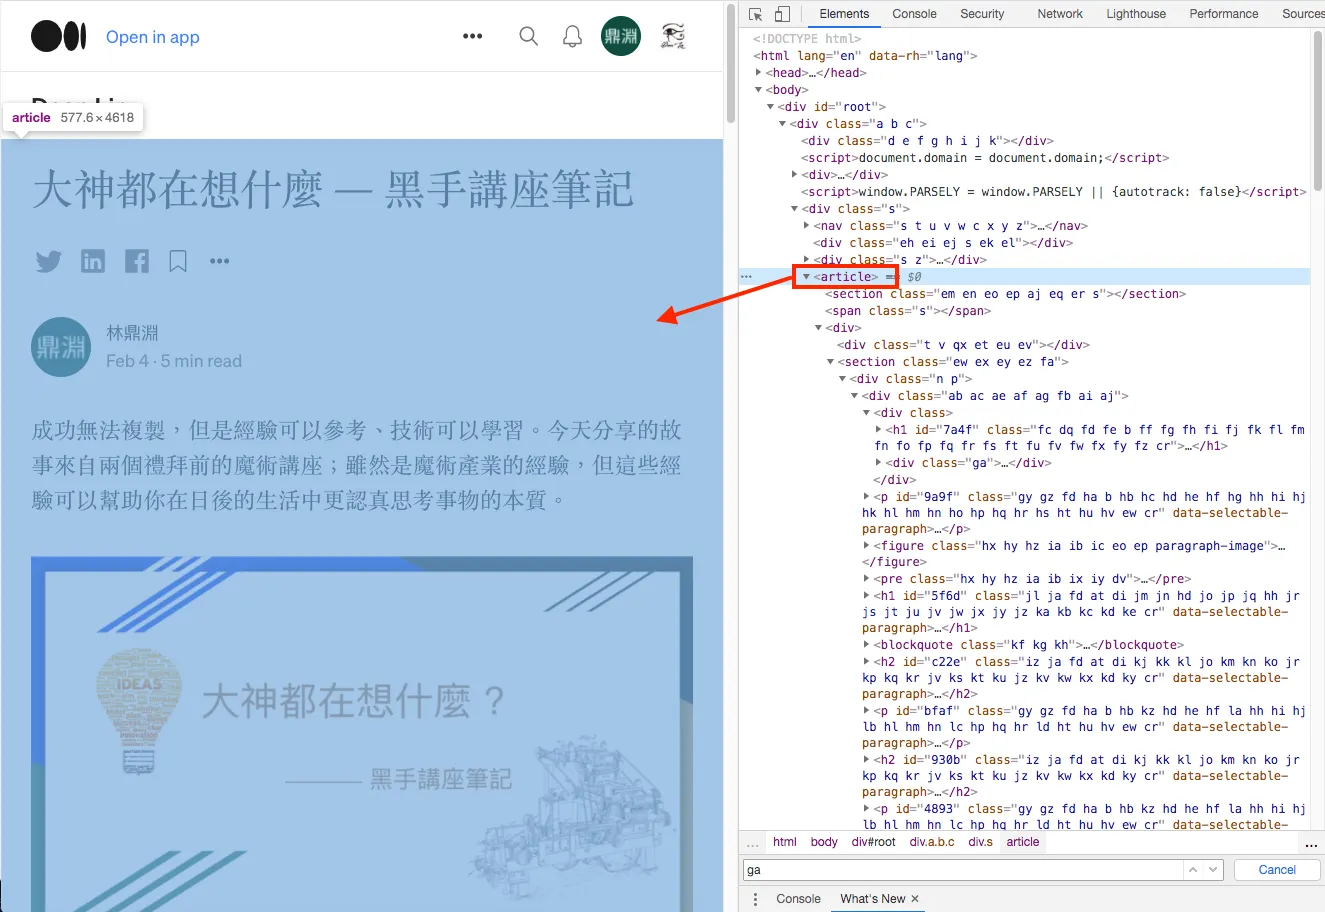
STEP 2: 分析文章中哪些 html tag 需要抓取
依據 Medium 文章的排版種類,以下是我們需要做字數統計的 tag:
- <h1>:大標題
- <h2>:小標題
- <p>:一般文字(包含粗體、斜體、連結)
- <span>:被包在 Block 裡面的文字(會被 html 的 pre tag 包住)
- <li>:列表的文字
- <figcaption>:照片的補充文字說明
二、確認爬蟲能正確抓取目標文字
如果你想培養完整爬蟲的程式能力,可以參考我在 IT邦幫忙鐵人賽的文章,本篇文章只單純提供演算法
STEP 1:在知道哪些網頁元素需要抓取後,我們就來嘗試看看能否抓到我們所希望的文字資訊
async function countStoryWords (driver) {
    try {
        let wordsCount = 0
        let article_tag_p = await driver.findElements(By.xpath(`//article//p`));
        let article_tag_h1 = await driver.findElements(By.xpath(`//article//h1`));
        let article_tag_h2 = await driver.findElements(By.xpath(`//article//h2`));
        let article_tag_span = await driver.findElements(By.xpath(`//article//span`));
        let article_tag_figcaption = await driver.findElements(By.xpath(`//article//figcaption`));
        let article_tag_li = await driver.findElements(By.xpath(`//article//li`));

        for (var k = 0; k < article_tag_p.length; k++) {
            let article_text = await article_tag_p[k].getText()
            console.log(article_text)
        }
      ...
      } catch (e) {
        console.error('計算 Story words 失敗')
        console.error(e)
        return 0
    }
}
原始碼:countStoryWords.js(GitHub Gist)
STEP 2:透過 console.log 的回饋,我們可以發現有一些資訊是不需要抓取的
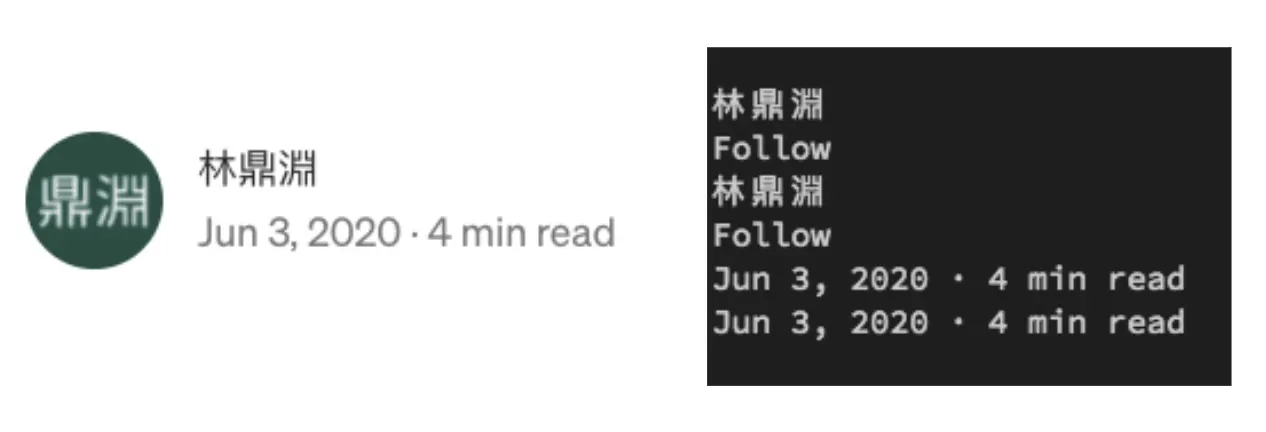
STEP 3:分析 html 的組成將多餘的資訊過濾
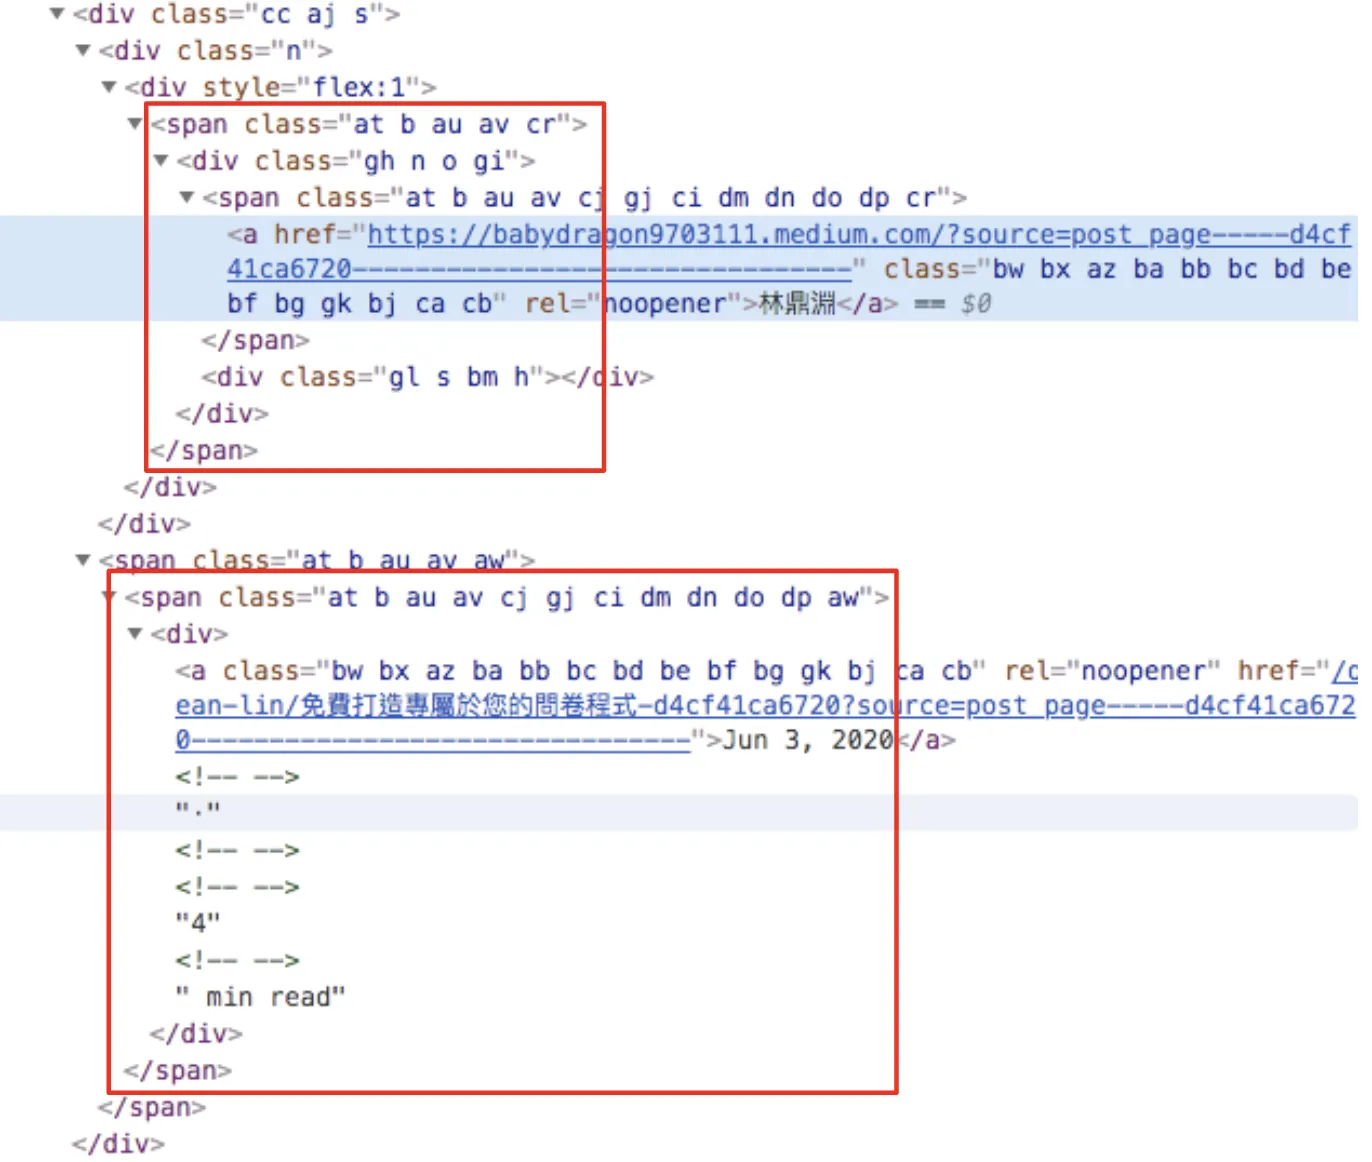
只要在 span tag 抓取文字的地方先判斷其 parent 的元素即可過濾
for (var k = 0; k < article_tag_span.length; k++) {
    // 要先過濾掉最上方作者資訊
    let parant_tag = await article_tag_span[k].findElement(By.xpath(`./..`)).getTagName();
    if (parant_tag != "div" && parant_tag != "span") {
        let article_text = await article_tag_span[k].getText()
        // console.log(article_text)
        // console.log(countWords(article_text))
        wordsCount = wordsCount + countWords(article_text)
    }
}
原始碼:filter_author.js(GitHub Gist)
三、設計字數統計的邏輯
STEP 1:文章抓下來的文字需要列入字數統計的有:中文、英文;其餘特殊字元不列入計算。
STEP 2:撰寫文字計算邏輯的 function
function countWords (str) {
    // 先將特殊字元用空白取代掉
    str = str.replace(/[\u007F-\u00FE]/g, ' ');

    // 複製兩個,一個用來算中文字數,一個計算英文字數
    let str1 = str;
    let str2 = str;

    // 移除中文,單純計算英文
    str1 = str1.replace(/[^!-~\d\s]+/gi, ' ')

    // 移除英文單純計算中文
    str2 = str2.replace(/[!-~\d\s]+/gi, '')

    let matches1 = str1.match(/[\u00ff-\uffff]|\S+/g);
    let matches2 = str2.match(/[\u00ff-\uffff]|\S+/g);

    count1 = matches1 ? matches1.length : 0;
    count2 = matches2 ? matches2.length : 0;

    /// 回傳總和
    const total = (count1 + count2);
    return total
}
原始碼:countWords.js(GitHub Gist)
四、實測確認可完成文章字數統計
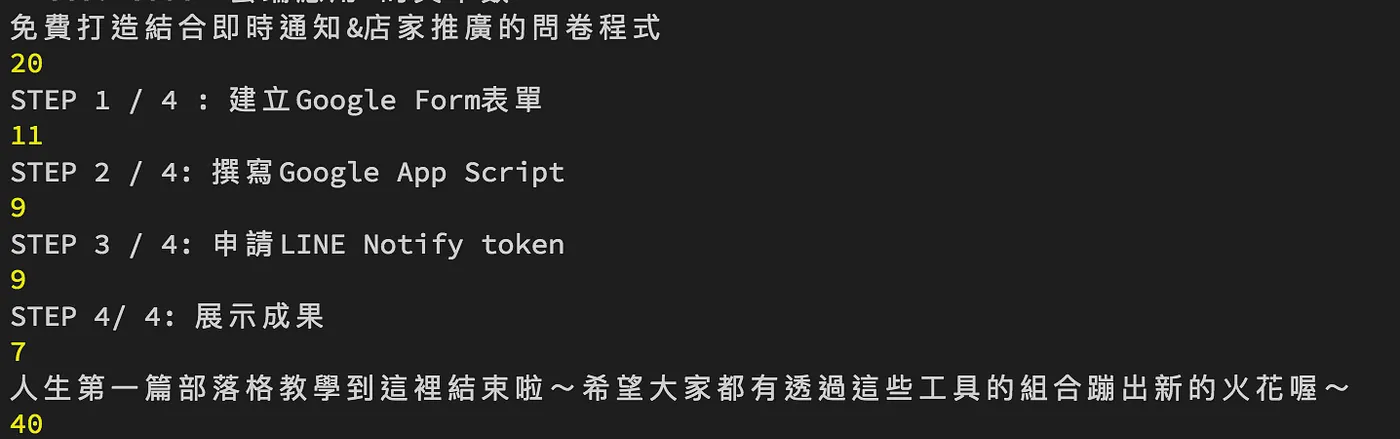
STEP 1:透過 console.log 印出列入計算的文字、計算出來的文字長度,確認是否與我們期望的相同
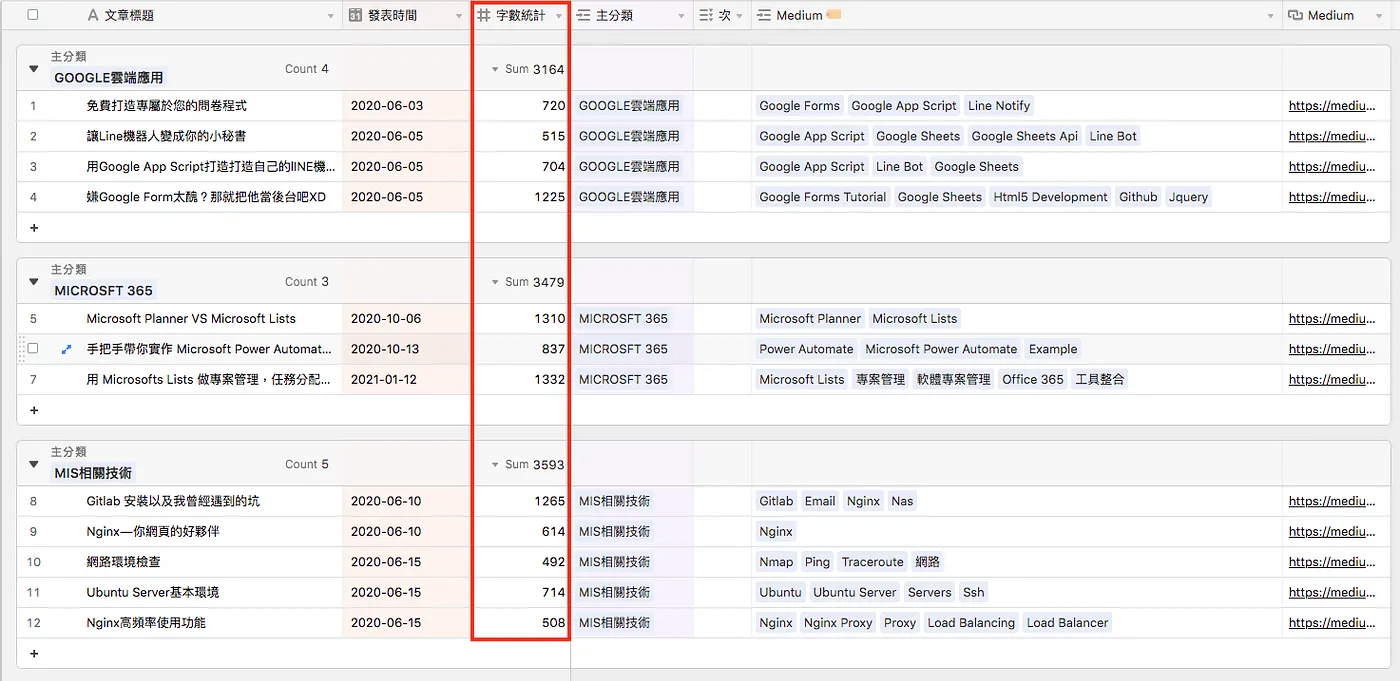
STEP 2:在 airtable 上面增加字數統計的爛位,將欄位的類型設定為number,確認匯入的資訊是否符合期望
五、未來展望
- 目前字數統計的功能只能給尚未爬蟲過的文章使用,故未來會考慮增加 update 舊文章資訊的 function
- 字數統計也許配合長條圖視覺話有更炫砲的效果,這塊也可以在考慮看看
完成的專案程式碼在這裡,歡迎有興趣的朋友自己動手玩玩看~

留言載入中…