用 Python 搭配 OpenAI 的 GPT、Whisper API 取得 Youtube 影片摘要

如果追求點擊率、按讚數,我應該要用「工程師要失業了!靠 ChatGPT 就能寫出取得 Youtube 影片摘要的程式!」來當標題。
也許隨著 AI 持續發展,這個標題在未來真的可以實現,但並不是現在。
儘管 ChatGPT 的出現,讓寫程式的門檻大幅降低;但現在還是有不少 ChatGPT 無法解決,或是解決不好的問題。
這篇文章會用範例讓讀者理解 ChatGPT 在寫程式上的侷限,以及適合使用的場景。
在前面的文章中,筆者已經實現用 Python 將 Youtube 影片轉逐字稿。
而在這篇文章,我將導入 OpenAI 的 GPT API,請他幫我們整理逐字稿,並取得影片摘要。
提醒大家,不要未經授權下載有版權保護的影片喔!
導入 OpenAI 的 GPT API,提升逐字稿可讀性
😀:「下面是我用 Python 寫的 Youtube 影片轉成逐字稿的程式,我想要在這個基礎上擴充功能,我在後續的對話中會提出自己的需求,請問你可以幫忙嗎?
from pytube import YouTube
from pydub import AudioSegment
import openai

# 設定要下載的影片 URL
url = "https://www.youtube.com/watch?v=IvOdTbIYZs4"

# 建立 YouTube 物件
yt = YouTube(url)

# 取得影片的音軌
audio_stream = yt.streams.filter(only_audio=True).first()

# 下載音軌到指定的路徑
audio_stream.download(output_path="path/to/save/directory", filename="audio")

# 讀取下載下來的音檔
audio_file = AudioSegment.from_file("path/to/save/directory/audio")

# 切割音檔成多個小檔案
chunk_size = 100 * 1000  # 100 秒
chunks = [audio_file[i:i+chunk_size] for i in range(0, len(audio_file), chunk_size)]

# 使用 OpenAI 的 Audio API 將每個小檔案轉成文字,然後合併在一起
openai.api_key = "YOUR_API_KEY"
transcript = ""
for chunk in chunks:
    with chunk.export("temp.wav", format="wav") as f:
        result = openai.Audio.transcribe("whisper-1", f)
        transcript += result["text"]

# 印出轉換後的文字
print(transcript)
因為 ChatGPT 的資料截止於 2021 年 9 月,此時的他對於未來世界並不了解,所以我們需要去官方找範例程式,請他協助合併。
這邊我們使用的是 OpenAI 的 Chat 功能:https://platform.openai.com/docs/api-reference/chat
😀:「我找到了一個可以整理逐字稿的套件,官方範例如下,我希望將最後的結果印出來,要如何將他與我現在的程式結合呢?
import os
import openai
openai.api_key = os.getenv("OPENAI_API_KEY")

completion = openai.ChatCompletion.create(
  model="gpt-3.5-turbo",
  messages=[
    {"role": "user", "content": "Hello!"}
  ]
)

print(completion.choices[0].message)
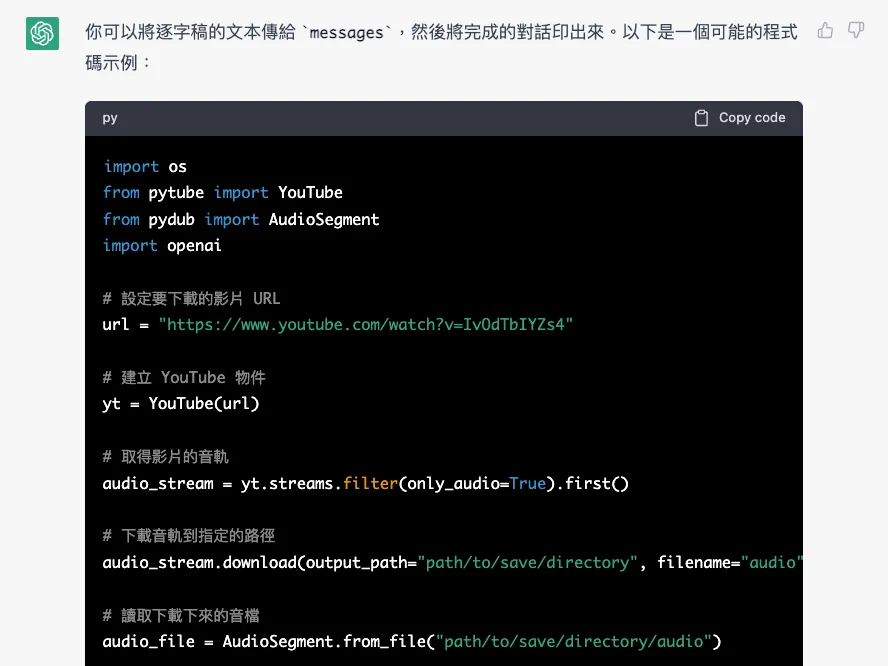
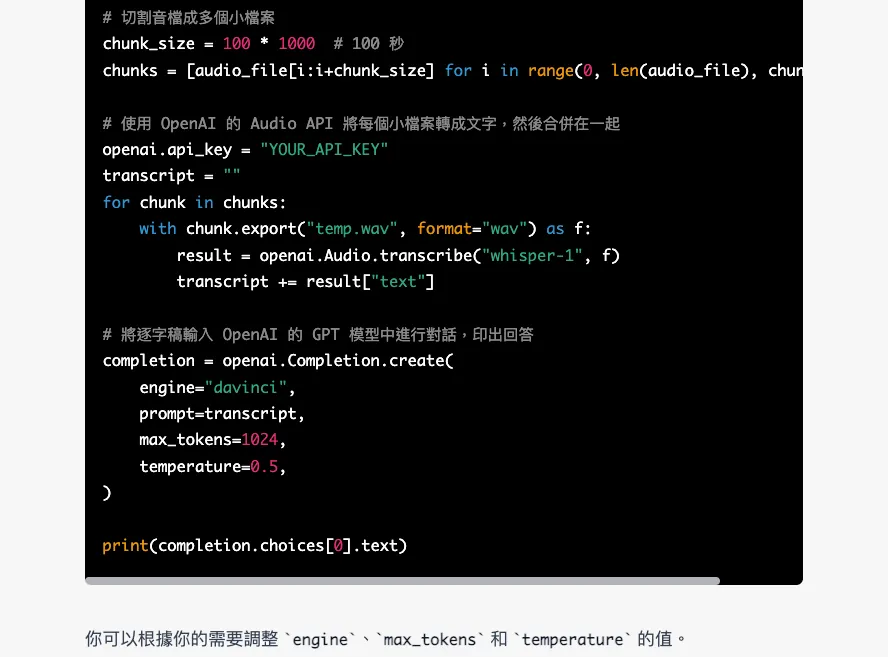
前面幾篇文章中,我們靠 ChatGPT 就能順利完成專案;但在這篇文章中,如果你缺乏程式的開發經驗就可能會卡很久。
首先,你有沒有發現 ChatGPT 根本不是使用我們提供的官方範例程式!如果你嘗試跑起來會出現各式各樣的錯誤:
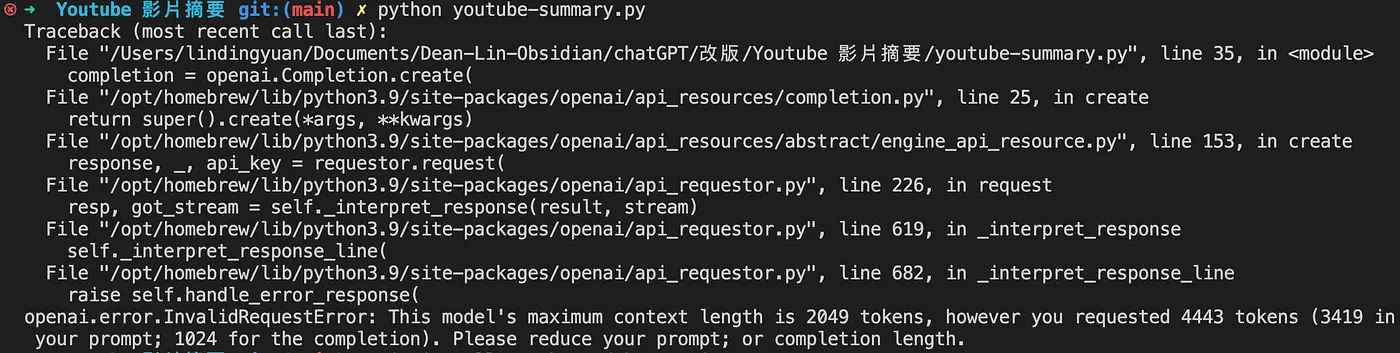
儘管筆者使用多種方式來調教他,最終也成功試出能夠讓 ChatGPT 吐出正確回應的指令,但這個指令不具有參考價值,因為我必須描述得非常詳細,如果使用方式太過複雜,那就不是一個值得分享的使用方式。
所以筆者還是靠自己整合出一個版本:
from pytube import YouTube
from pydub import AudioSegment
import openai

# 設定要下載的影片 URL
url = "https://www.youtube.com/watch?v=IvOdTbIYZs4"

# 建立 YouTube 物件
yt = YouTube(url)

# 取得影片的音軌
audio_stream = yt.streams.filter(only_audio=True).first()

# 下載音軌到指定的路徑
audio_stream.download(output_path="path/to/save/directory", filename="audio")

# 讀取下載下來的音檔
audio_file = AudioSegment.from_file("path/to/save/directory/audio")

# 切割音檔成多個小檔案
chunk_size = 100 * 1000  # 100 秒
chunks = [audio_file[i:i+chunk_size] for i in range(0, len(audio_file), chunk_size)]

# 使用 OpenAI 的 Audio API 將每個小檔案轉成文字,然後合併在一起
openai.api_key = "YOUR_API_KEY"
transcript = ""
for chunk in chunks:
    with chunk.export("temp.wav", format="wav") as f:
        result = openai.Audio.transcribe("whisper-1", f)
        transcript += result["text"]

# 整理逐字稿
completion = openai.ChatCompletion.create(
  model="gpt-3.5-turbo",
  messages=[
    {"role": "user", "content": "使用繁體中文閱讀,幫我改錯字、加標點符號,並分段使內容更通順:\n"+transcript}
  ]
)

# 印出整理後的文字
print(completion.choices[0].message.content)
STEP 1:安裝相關 Python 套件,pip install pytube pydub openai
STEP 2:建立一個youtube-summary.py的檔案,貼上 ChatGPT 的程式。
STEP 3:在終端機輸入python youtube-summary.py,然後稍等一段時間…就會看到成果啦!
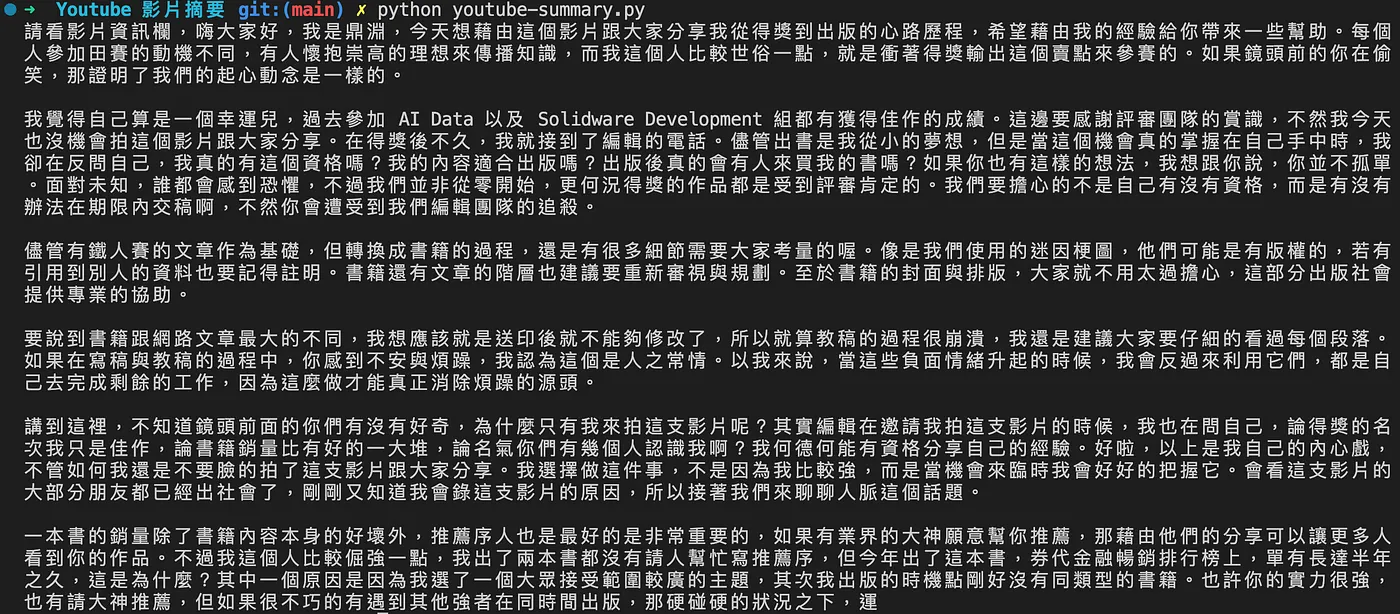
表面上看起來整理得挺不錯,但仔細看會發現結尾突然斷掉了,這是為什麼呢?
這邊用 OpenAI 官方文件比較好說明,每個 GPT 模型都有自己的 max_tokens,我們選用的 gpt-3.5-turbo 最高上限是 4096。
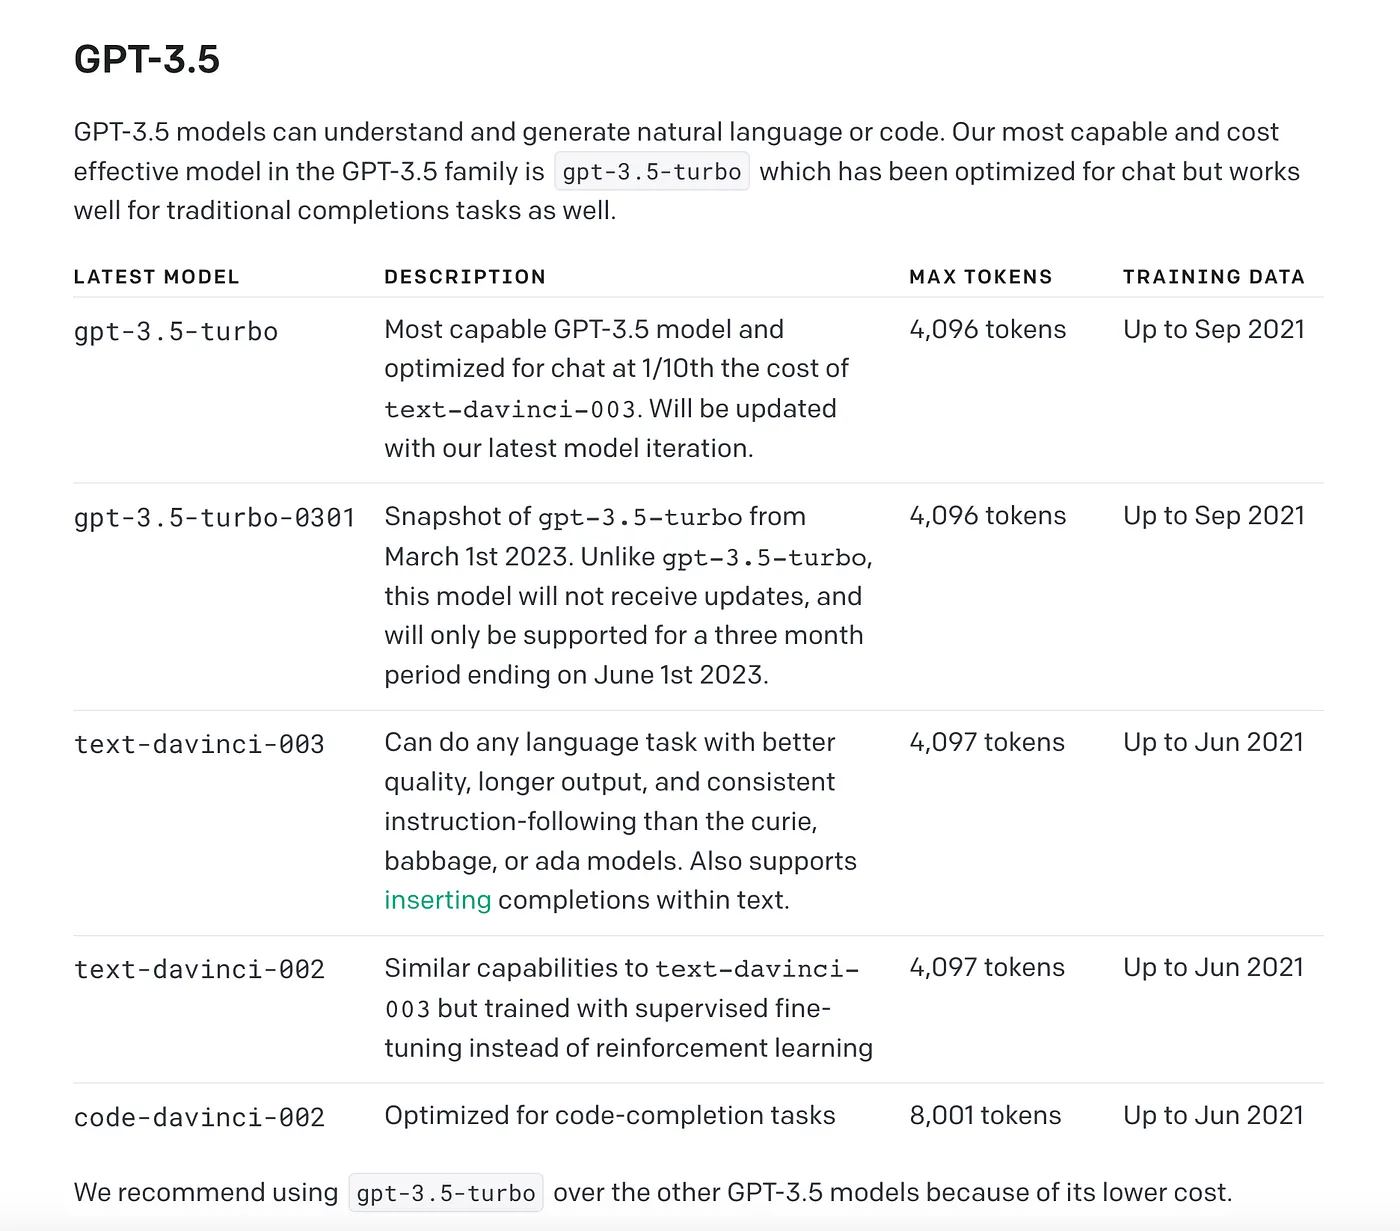
所以截斷的原因就是我們的 prompt 太長了,這邊跟大家科普一下,所謂 prompt 長度就是我們傳入的逐字稿長度。
而中文跟英文計算 Token 的方式也不盡相同,如果使用英文,1000 個 tokens 大約等於 750 個單字;但如果使用中文,1000 個 tokens 大約只有 400 字。
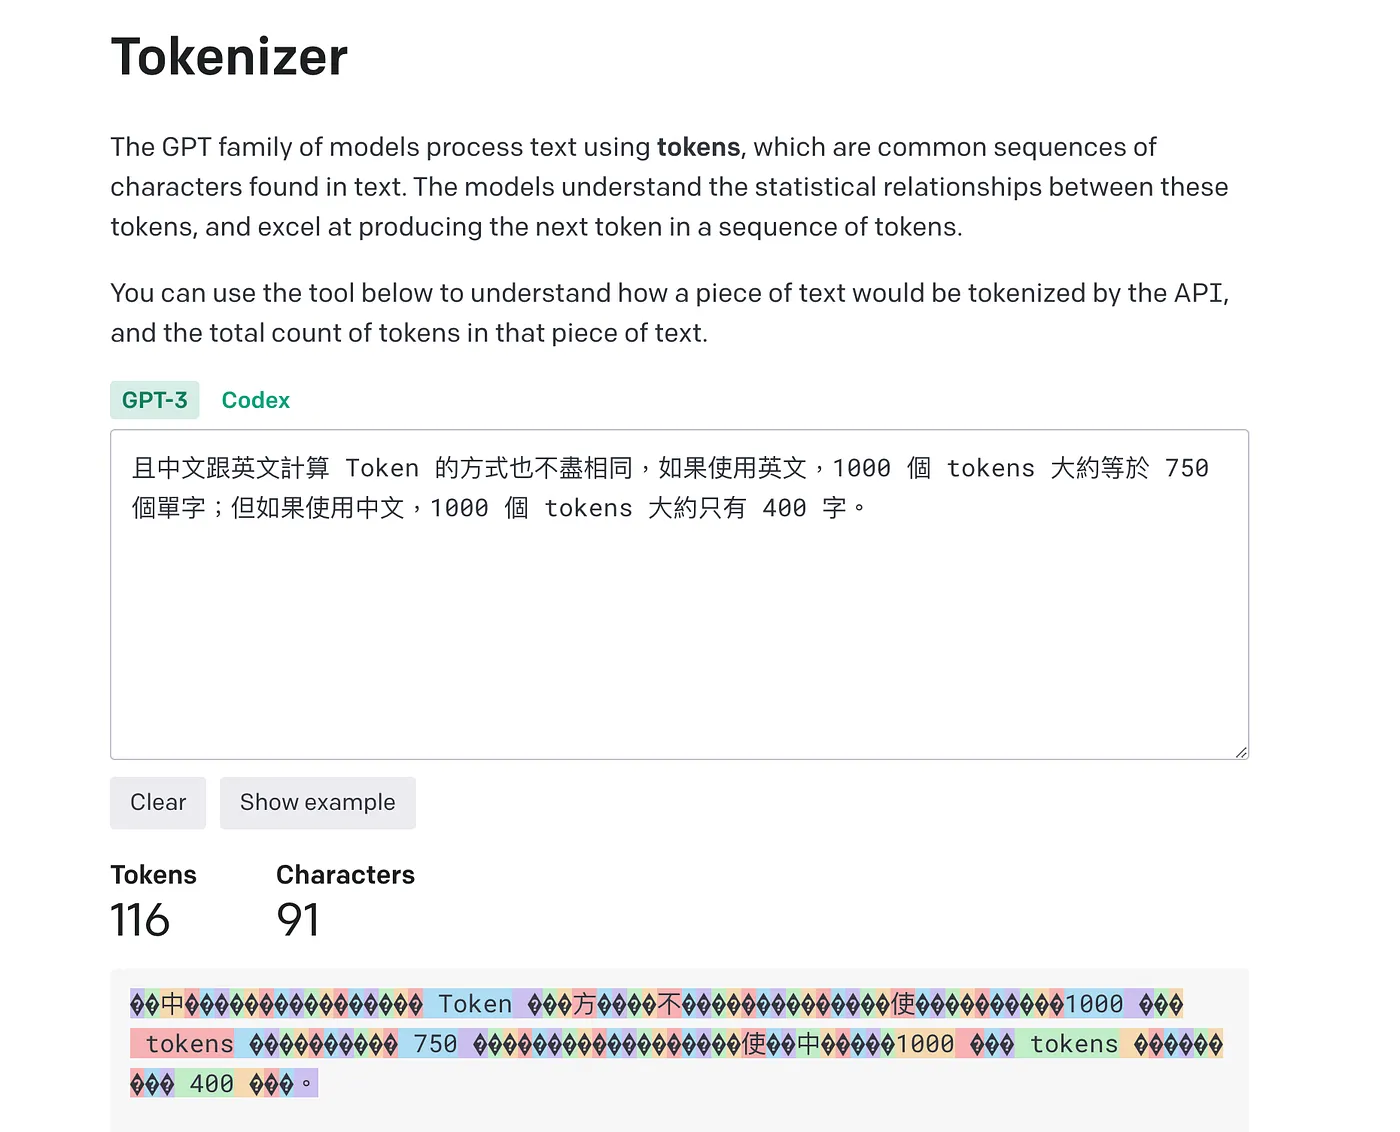
上面是補充說明,讓我們回到原本的話題,我們要如何讓逐字稿完整的被整理,不要被截斷呢?
最直覺的做法就是將逐字稿「分段」傳送過去,4096 的 token 換算成中文大約 1600 字,我們保守一點,用「1200」的長度來做分割,下面是整理好的程式。
from pytube import YouTube
from pydub import AudioSegment
import openai

# 設定要下載的影片 URL
url = "https://www.youtube.com/watch?v=IvOdTbIYZs4"

# 建立 YouTube 物件
yt = YouTube(url)

# 取得影片的音軌
audio_stream = yt.streams.filter(only_audio=True).first()

# 下載音軌到指定的路徑
audio_stream.download(output_path="path/to/save/directory", filename="audio")

# 讀取下載下來的音檔
audio_file = AudioSegment.from_file("path/to/save/directory/audio")

# 切割音檔成多個小檔案
chunk_size = 100 * 1000  # 100 秒
chunks = [audio_file[i:i+chunk_size] for i in range(0, len(audio_file), chunk_size)]

# 使用 OpenAI 的 Audio API 將每個小檔案轉成文字,然後合併在一起
openai.api_key = "YOUR_API_KEY"
transcript = ""
for chunk in chunks:
    with chunk.export("temp.wav", format="wav") as f:
        result = openai.Audio.transcribe("whisper-1", f)
        transcript += result["text"]

# 依照我們指定的長度分割字串
def split_text(text, max_length):
    return [text[i:i+max_length] for i in range(0, len(text), max_length)]

# 整理逐字稿
def process_text(text):
    response = openai.ChatCompletion.create(
        model="gpt-3.5-turbo",
        messages=[
            {"role": "system", "content": "You are a helpful assistant."},
            {"role": "user", "content": "使用繁體中文閱讀,幫我改錯字、加標點符號,並分段使內容更通順:\n"+text}
        ]
    )
    return response.choices[0].message.content

# 處理長字串
def process_long_text(long_text):
    text_list = split_text(long_text, 1200)
    processed_text_list = [process_text(text) for text in text_list]
    return "".join(processed_text_list)

# 呼叫分段處理函式
processed_transcript = process_long_text(transcript)

# 印出處理後的逐字稿
print(processed_transcript)
在終端機輸入python youtube-summary.py,就會看到被分段,並加上標點符號的成果啦!
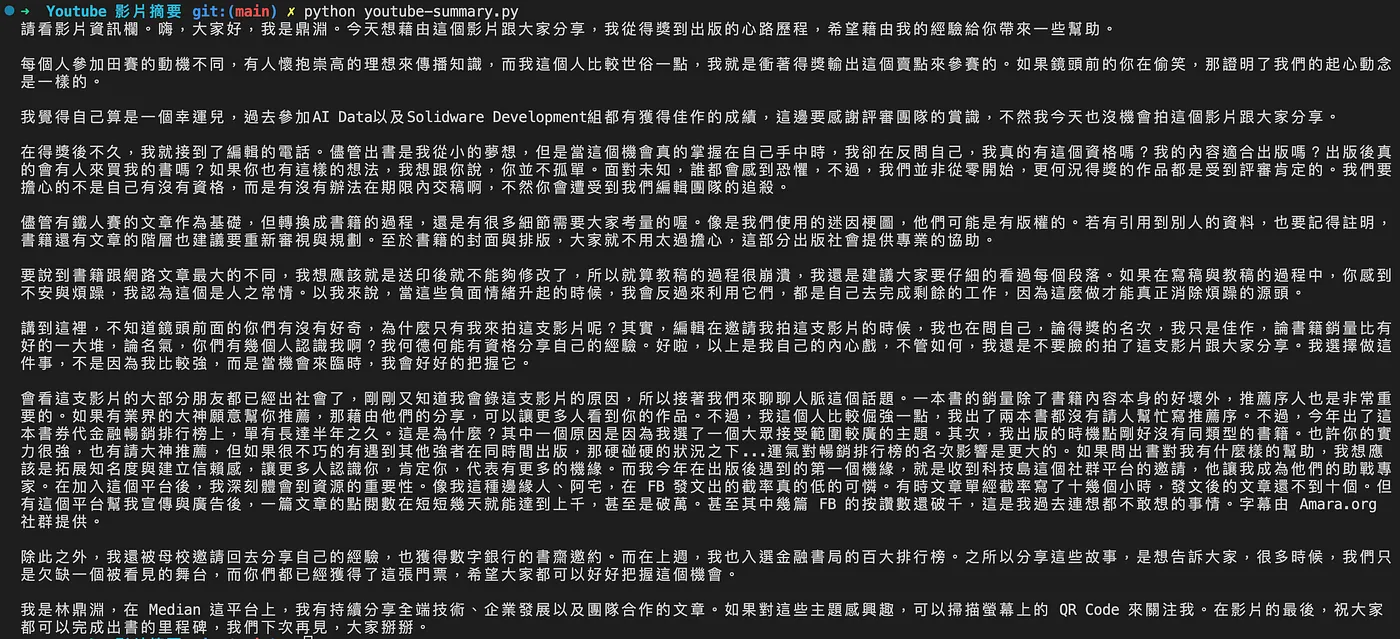
關於字串分割的方式,筆者是向 ChatGPT 詢問:「我逐字稿的字數可能超過 1 萬字,而這個 api 最多只能讀 1200 字,請問我要如何改寫?」改編而來的;儘管 ChatGPT 面對新套件力有不逮,但基礎的問題還是可以順利回答。
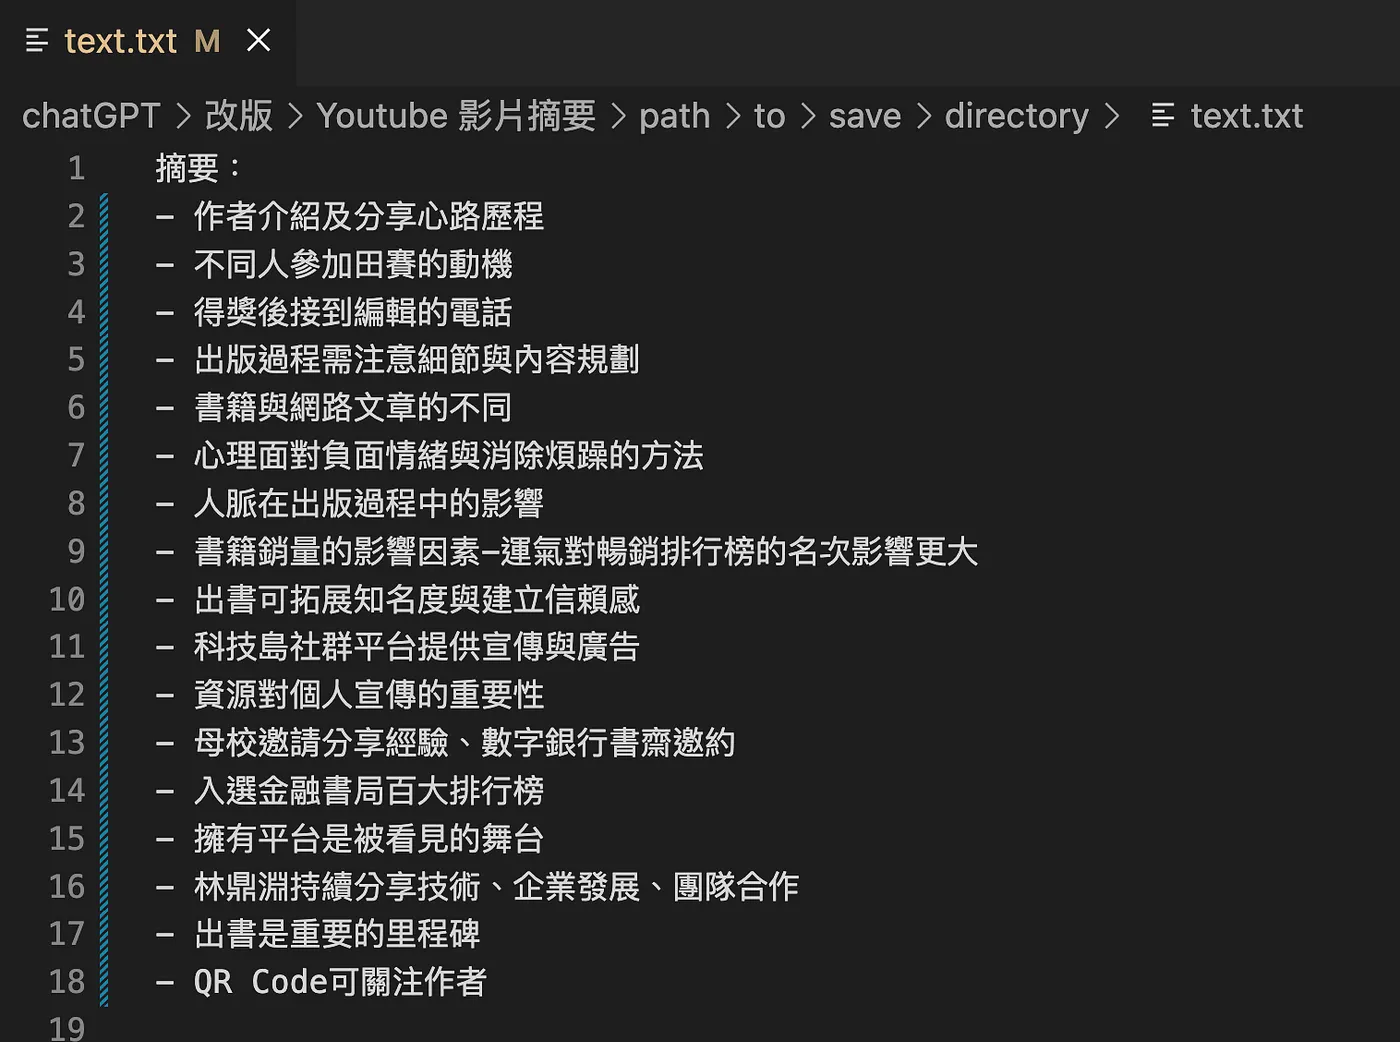
取得逐字稿摘要,轉成 txt 格式
基本上下面的程式就是筆者自己改造的了,我做了兩件事:
- 在
process_long_text函式增加了一個type的參數,裡面可以放置不同類型的 prompt(ex:整理逐字稿、摘要)。 - 將整理好的文字寫入 txt 檔案。
from pytube import YouTube
from pydub import AudioSegment
import openai

# 設定要下載的影片 URL
url = "https://www.youtube.com/watch?v=IvOdTbIYZs4"

# 建立 YouTube 物件
yt = YouTube(url)

# 取得影片的音軌
audio_stream = yt.streams.filter(only_audio=True).first()

# 下載音軌到指定的路徑
audio_stream.download(output_path="path/to/save/directory", filename="audio")

# 讀取下載下來的音檔
audio_file = AudioSegment.from_file("path/to/save/directory/audio")

# 切割音檔成多個小檔案
chunk_size = 100 * 1000  # 100 秒
chunks = [audio_file[i:i+chunk_size]
          for i in range(0, len(audio_file), chunk_size)]

# 使用 OpenAI 的 Audio API 將每個小檔案轉成文字,然後合併在一起
openai.api_key = "YOUR_API_KEY"
transcript = ""
for chunk in chunks:
    with chunk.export("temp.wav", format="wav") as f:
        result = openai.Audio.transcribe("whisper-1", f)
        transcript += result["text"]


# 依照我們指定的長度分割字串
def split_text(text, max_length):
    return [text[i:i+max_length] for i in range(0, len(text), max_length)]

# 依照 type 處理文字
def process_text(text, type):
    response = openai.ChatCompletion.create(
        model="gpt-3.5-turbo",
        messages=[
            {"role": "system", "content": "You are a helpful assistant."},
            {"role": "user", "content": type + text}
        ]
    )
    return response.choices[0].message.content

# 處理長字串
def process_long_text(long_text, type):
    text_list = split_text(long_text, 1200)
    processed_text_list = [process_text(text, type) for text in text_list]
    return "".join(processed_text_list)


# 呼叫分段處理函式
processed_transcript = process_long_text(transcript, "使用繁體中文閱讀,幫我改錯字、加標點符號,並分段使內容更通順:\n")

# 呼叫取得摘要函式
processed_summary = process_long_text(processed_transcript, "閱讀以下文字,用「-」作為前綴條列出重點,用「繁體中文」呈現:\n")

with open("path/to/save/directory/text.txt", "w") as file:
    file.write("摘要:\n" + processed_summary + "\n\n\n逐字稿:\n" + processed_transcript)
在終端機輸入python youtube-summary.py,就會看到「Youtube 摘要、整理過的逐字稿」被寫入 txt 檔案中啦!
筆者想說的話
不知道有多少人會把文章看完,但其實這篇文章我寫得很沮喪。
程式的部分我花不到 1 小時就完工,但文章卻寫了 4 個多小時,我不停在思考怎麼樣的呈現方式對讀者來說是有幫助的。
最終我選擇了上面的呈現方式,任何工具都有不完美的地方,沒必要所有事情都依賴 ChatGPT。
以這篇文章完成的功能來說,ChatGPT 的幫助如下:
- 提供字串分割的函式
- 寫入 txt 檔案的方式
其他部分基本上都是筆者自己改寫的,並不是說 ChatGPT 絕對辦不到,只是想表達工具用在對的地方才會有最大效益(ex:基礎程式、簡單除錯、最小可執行程式),我也不想只呈現完美的路徑。
最後再聊聊自己為什麼會寫這個 Side Project 吧。
我這個人喜歡閱讀文章大過看影片,因為我可以在文章中快速找到自己需要的重點,而觀看影片很難讓我做到這件事。
如果看影片是為了娛樂,那我會享受這個過程;但有時看影片是為了吸收知識,那這樣的效率對我來說就太慢了,所以我就做了這個小工具,提升自己吸收知識的效率。
我喜歡依照自己的「節奏」來吸收資訊,而閱讀滿足了這點。
AI 實戰 實測生成式 AI 工具、Vibe Coding 與自動化流程的第一手心得,把 AI 變成每天都用得上的即戰力。 林鼎淵 Dean Lin
想將 AI 導入自己的職場與生活嗎?歡迎購買筆者出版的新書,幫助您在 AI 的浪潮中站穩腳步,並在未來的職場競爭中佔據優勢!


留言載入中…